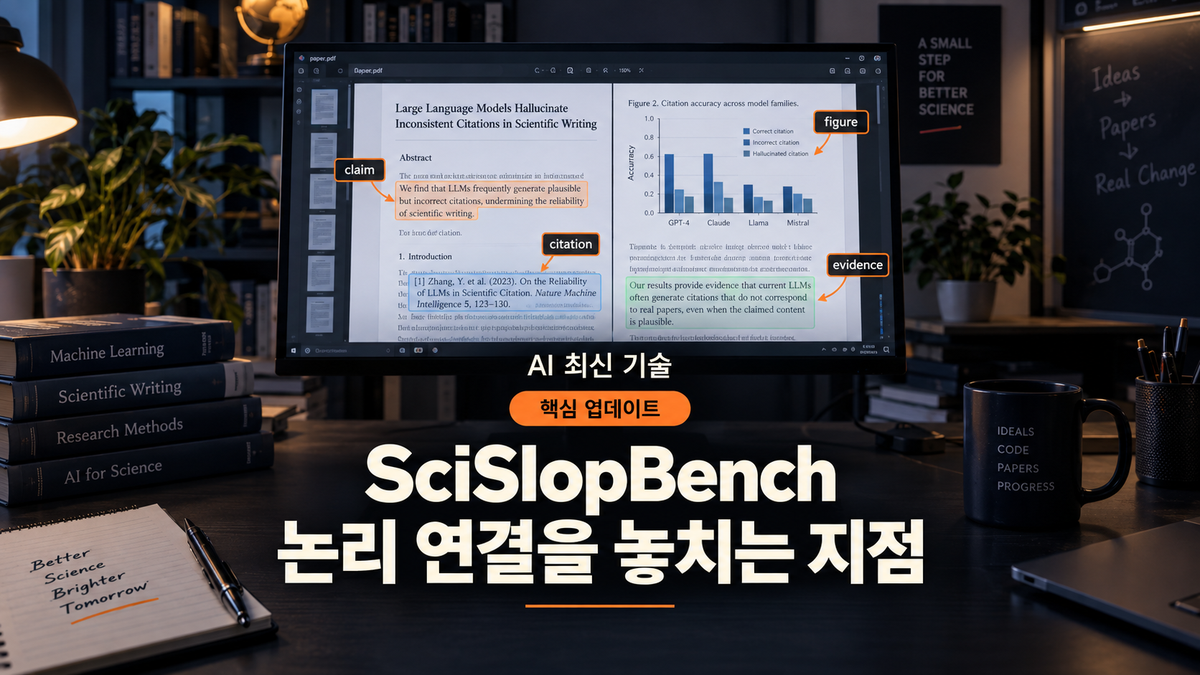
SciSlopBench, AI 논문이 그럴듯해도 논리 연결을 놓치는 지점
초록은 매끈하고 문장도 틀린 곳이 없어 보이는데, 방법을 읽고 결과표로 넘어가면 “그래서 이 주장이 어디서 나온 거지?”라는 순간이 생깁니다. SciSlopBench는 이런 문제를 문장 하나의 자연스러움이 아니라 논문 전체의 연결 관계로 검사합니다. 다만 점수가 AI 작성 확률이나 과학적 진실 판정은 아닙니다.
그럴듯한 문장과 이어지는 과학적 추론은 같은 말이 아닙니다.
30초 요약
SciSlopBench는 AI 생성 논문과 인간 작성 논문을 같은 연구 문제·기여 유형끼리 짝지어 비교합니다.
검사는 구조, 논증, 산출물의 세 plane에서 여섯 패턴을 셉니다.
핵심 단위는 문장 예측 가능성이 아니라 섹션·주장·인용·그림·구체 사례의 연결입니다.
논문이 보고한 전체 PairAcc는 0.859였지만, 이는 390쌍 벤치마크 안의 결과입니다.
공식 데모의 지수는 AI 작성 확률이 아니므로 사람이 근거와 맥락을 다시 읽어야 합니다.
논문 전체를 봐야 하는 이유
문장 단위 AI 탐지기는 보통 문체나 토큰의 예측 가능성을 봅니다. 반면 SciSlop은 한 문장이 자연스러운지보다, 서론의 주장이 방법·실험·그림·결과와 실제로 이어지는지를 묻습니다.
생활 비유로 말하면, 부품 하나씩은 멀쩡한데 조립 설명서의 연결 나사가 빠진 상태에 가깝습니다. 부품 검사는 통과해도 완성품이 제대로 움직인다는 뜻은 아닙니다.
SciSlopBench의 질문은 ‘AI가 썼나?’보다 ‘논문의 과학적 추론이 연결돼 있나?’에 가깝습니다. 그래서 문장 교정만으로는 사라지지 않는 문제를 별도로 다룹니다.
SciSlopBench는 무엇을 세나
논문은 여섯 측정 항목을 구조(Structure), 논증(Argument), 산출물(Artifacts)의 세 묶음으로 설명합니다. 각 항목은 일정한 단위에서 문제가 보이는 비율을 계산하고, 공식 데모는 적용되지 않는 항목을 0점으로 넣지 않고 건너뛴다고 안내합니다.
| 측정 항목 | 쉽게 풀면 | 작은 예시 |
|---|---|---|
| Cross-section references | 다른 섹션의 표·그림·내용을 실제로 연결하는가 | 결과에서 언급한 그림을 방법이나 결론이 전혀 받지 않음 |
| Macro redundancy | 뒤 섹션이 앞 내용을 반복만 하는가 | 결과가 방법 설명을 거의 그대로 되풀이함 |
| Argument graph | 핵심 주장을 뒷받침하는 앞선 근거가 있는가 | 결론 같은 주장이 근거보다 먼저 튀어나옴 |
| Citation isolation | 인용이 왜 필요한지 비교·관계가 설명되는가 | 논문 이름만 줄줄이 놓고 차이를 말하지 않음 |
| Figure exposition | 방법 그림이 작동 순서를 보여주는가 | 하이퍼파라미터는 많은데 데이터 흐름은 안 보임 |
| Evidence gap | 결과표를 구체 사례로 들여다볼 수 있는가 | 평균 점수만 있고 입력·출력 사례가 없음 |
여섯 점수는 ‘틀린 문장’의 개수가 아니라 연결이 끊긴 단위의 비율입니다. 따라서 하나의 숫자만 보고 논문이 나쁘다고 단정하면 측정 목적을 벗어납니다.
점수는 어떻게 만들어지나
공식 데모의 설명에 따르면 네 항목은 정해진 규칙으로 세고, argument graph와 figure exposition은 언어 모델이 문장이나 방법 그림을 라벨링합니다. 각 항목 점수를 plane 안에서 평균한 뒤 세 plane의 평균을 내어 100점 척도로 보여줍니다.
예를 들어 결과표가 있지만 논문 어디에도 입력과 출력 사례가 없다면 evidence gap에서 표시될 수 있습니다. 반대로 특정 연구에서는 사례가 핵심이 아니어서 그 항목이 적용되지 않을 수 있고, 공식 데모는 이런 항목을 0점으로 간주하지 않습니다.
공식 지수의 높은 값은 ‘AI일 확률’이 아니라 해당 패턴이 얼마나 나타났는지를 뜻합니다.
문서 기반 예시로 SciSlop의 출력은 “이 논문은 AI입니다”가 아니라 “결과표 주변에 구체 사례가 부족하고, 이 그림의 참조가 섹션 사이에서 끊겼다”에 가까워야 합니다. 실제 분석을 실행한 기록은 아니며, 작동 원리를 설명하기 위한 예시입니다.

390쌍 비교 결과를 어디까지 믿을까
SciSlopBench는 FARS와 Agents4Science 2025에서 모은 AI 생성 논문 390편을 인간 작성 논문과 짝지었습니다. 짝은 연구 문제와 기여 유형을 맞추려 했고, 논문 설명상 컴퓨터과학 비중이 크지만 생명·사회·자연과학도 포함합니다.
원 논문이 보고한 전체 PairAcc는 0.859였습니다. 같은 표에서 Binoculars는 0.687, full-text 자동 리뷰어 중 최고치는 0.685였고, cross-section references 단독 항목은 0.905였습니다.
| 수치 | 읽는 법 |
|---|---|
| PairAcc 0.859 | 이 벤치마크의 짝 비교에서 human 논문을 더 낮은 slop 쪽으로 올바르게 순위화한 비율 |
| 390쌍 | 연구 문제·기여 유형을 맞춘 비교 집합의 크기 |
| 단일 항목 0.905 | cross-section references가 이 집합에서 보인 PairAcc |
수치는 인상적이지만, 특정 학회·분야·언어·작성 도구에서 같은 성능이 나온다고 말해주지는 않습니다. 인간 비교군도 top-tier venue 수락 논문으로 선별됐다는 데이터 구성의 영향을 받으므로, 현실의 모든 인간 논문을 대표한다고 볼 수 없습니다.
이 결과는 ‘문장 탐지보다 paper-level 신호가 유용할 수 있다’는 근거이지, 자동 판정기의 합격증은 아닙니다.
데모를 쓸 때 생기는 실제 한계
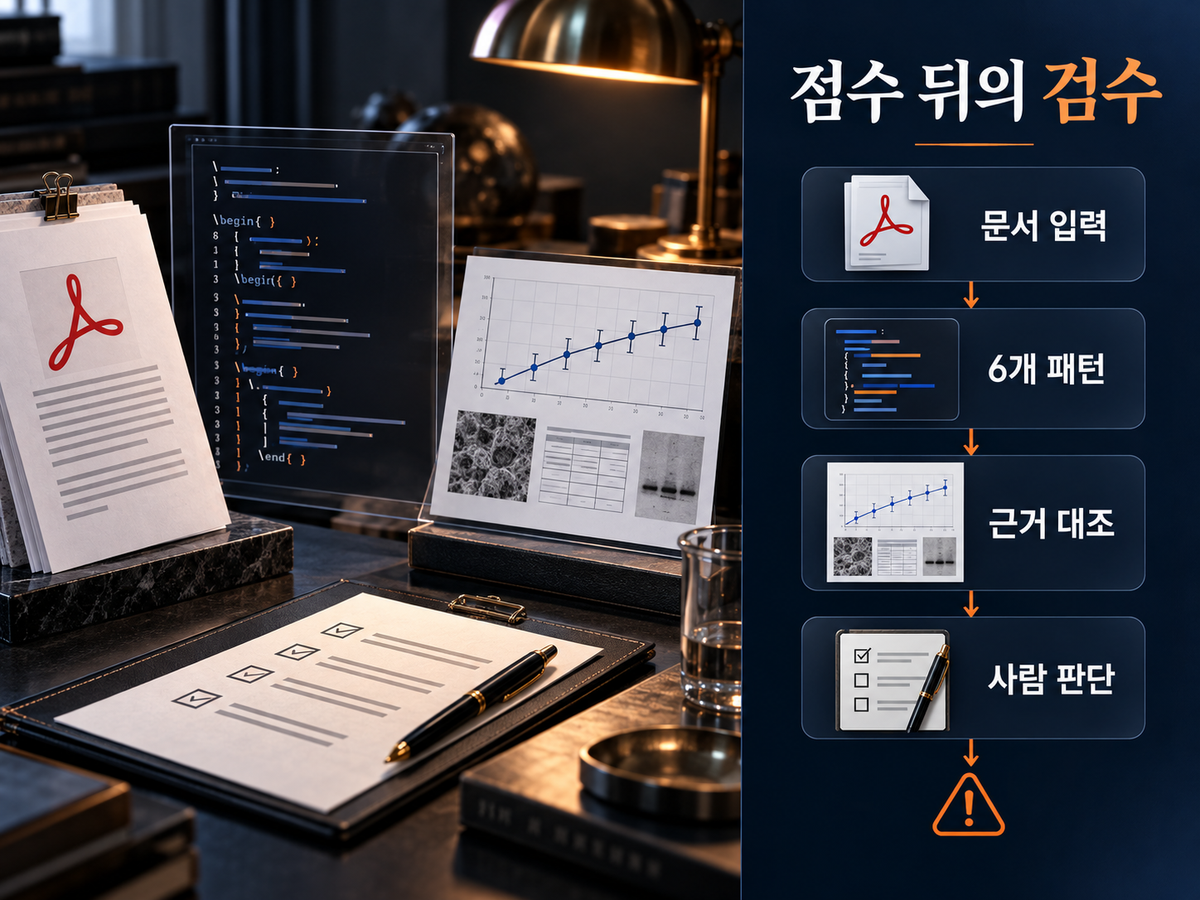
공식 데모는 PDF나 LaTeX zip을 받아 LaTeX 소스를 직접 읽거나 PDF를 섹션·캡션·참고문헌·인용 구조로 재구성한다고 설명합니다. 네 항목은 규칙 기반이고 두 항목은 모델 판단이 들어가므로, 입력 형식과 구조 복원 품질이 결과에 영향을 줄 수 있습니다.
또한 인용이 적은 짧은 논문, 그림이 없는 논문, 결과표가 없는 논문은 일부 항목이 적용되지 않습니다. 지수가 모든 항목을 똑같이 평가하지 않는다는 뜻이 아니라, 측정 가능한 단위가 있는 항목만 평균에 들어간다는 뜻입니다.
논리 연결이 좋다고 해서 데이터가 진짜라는 보장도 없습니다. 반대로 사람 연구자가 쓴 논문도 설명이 생략됐거나 그림 참조가 약하면 표시될 수 있습니다.
SciSlop은 검수의 시작점이지 동료평가와 재현 실험을 대신하지 않습니다.
어떤 독자에게 맞고, 언제는 부족한가
AI가 만든 초안을 연구 기록과 대조하려는 사람, 논문 리뷰 전에 구조적 빈틈을 훑고 싶은 사람에게는 유용한 관점입니다. 특히 문법 교정기를 통과한 뒤에도 주장·인용·그림·사례를 한 번에 점검해야 할 때 여섯 항목이 체크리스트 역할을 합니다.
반면 논문이 사실인지, 실험이 재현되는지, 통계 분석이 적절한지까지 자동으로 확인하는 도구는 아닙니다. 대안으로는 사람이 claim-evidence-citation 표를 만들고, 코드·실험 출력·원문헌을 직접 대조하는 절차가 필요합니다.
실무에서는 점수부터 낮추려 하지 말고 표시된 단위를 원고의 근거와 비교하는 편이 안전합니다. 논문은 SciSlop 점수를 줄이기 위해 억지로 그림 참조나 사례를 추가하는 순간 또 다른 연결 문제를 만들 수 있습니다.
작업 환경을 함께 정리한다면
논문 PDF와 실험 기록을 나란히 열어 표시하는 작업에 직접 필요한 제품만 별도로 확인합니다. MacBook에 여러 화면과 주변 장치를 연결해 비교 작업을 정리하려는 경우에는 아래 도킹 스테이션을 살펴볼 수 있습니다.
MacBook에서 PDF·원고·실험 출력 화면을 나란히 비교할 때 HDMI 화면 연결이 필요하다면 아래 USB-C 허브가 다른 역할을 맡습니다.
이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
출처
- Science or Slop?: Benchmarking and Mitigating Scientific Slop in AI-Generated Papers — arXiv, 2026-09-30 v1 확인
- Science Slop Index 공식 데모 — 측정 흐름·지수 설명, 2026-10-05 확인
핵심 정리: 다섯 가지 질문과 답
Q. SciSlopBench는 무엇을 검사하나요?
논문 전체에서 섹션·주장·인용·그림·구체 사례가 이어지는 방식을 여섯 패턴으로 검사합니다.
Q. 문장 단위 AI 탐지기와 가장 큰 차이는 무엇인가요?
토큰이나 문체보다 paper-level 연결 관계를 측정한다는 점입니다.
Q. SciSlop 점수가 높으면 AI가 쓴 논문인가요?
아닙니다. 공식 지수는 AI 작성 확률이 아니라 측정된 패턴의 정도를 나타냅니다.
Q. 0.859라는 수치는 무엇을 뜻하나요?
SciSlopBench의 390쌍 비교에서 보고된 전체 PairAcc이며, 모든 논문에 대한 실사용 정확도는 아닙니다.
Q. 실제 검수에서는 어떻게 써야 하나요?
표시된 구간을 원 논문·코드·실험 출력·인용과 대조하고, 사람의 최종 판단과 재현 검토를 이어가야 합니다.
글을 읽어 주셔서 감사합니다.
이 글이 도움이 되었고 새로운 정보를 계속 받아보고 싶으시다면 구독해 주세요.
'AI > AI 최신 기술' 카테고리의 다른 글
| AgentWorld, 에이전트가 오래 같이 일할수록 계획이 무너지는 이유 (0) | 2026.09.29 |
|---|---|
| TimeEvo, 전문가 도구를 넣기 전 무엇이 깨지는지 보는 채택 게이트 (0) | 2026.09.29 |
| SLCA-GRPO, 도구 호출은 맞는데 요약 보상에 흔들릴 때 토큰별 책임을 나누는 법 (0) | 2026.09.28 |
| PISA 블록 희소 어텐션, O(N log N)이라 믿기 전 봐야 할 계산 범위 (0) | 2026.09.28 |
| AgentKernel 프롬프트 인젝션, 도구 실행 전에 어디서 끊어야 할까 (0) | 2026.09.27 |


댓글