TimeEvo, 전문가 도구를 넣기 전 무엇이 깨지는지 보는 채택 게이트
대시보드에서 시계열 질문을 처리하는 AI에 분석 도구를 더 붙이면, 보통은 답이 좋아질 것이라 기대합니다. 그런데 도구가 늘어도 기존 정답을 망가뜨리지 않는지는 별도로 확인해야 합니다. TimeEvo는 이 문제를 평균 점수 대신 같은 질문의 ‘고친 답’과 ‘망가진 답’을 짝지어 보는 채택 게이트로 다룹니다.
30초 요약
- TimeEvo는 실패를 분석해 필요한 측정 도구 후보를 만들고, 후보가 기존 정답을 해치지 않는지 함께 봅니다.
- 논문 실험에서는 21개 전문가 선별 도구가 일부 시계열 과제, 특히 anomaly 과제에서 세 백본 모두 성능을 낮췄다고 보고했습니다.
- 도구 채택의 핵심은 ‘평균 점수가 올랐나’가 아니라 ‘무엇을 고쳤고 무엇을 망가뜨렸나’입니다.
- 저장소 README는 현재
Code is coming soon상태입니다. 이 글은 실행 후기가 아니라 논문 v1 기반 해설입니다.
전문가 도구가 왜 오히려 답을 흔들까요?
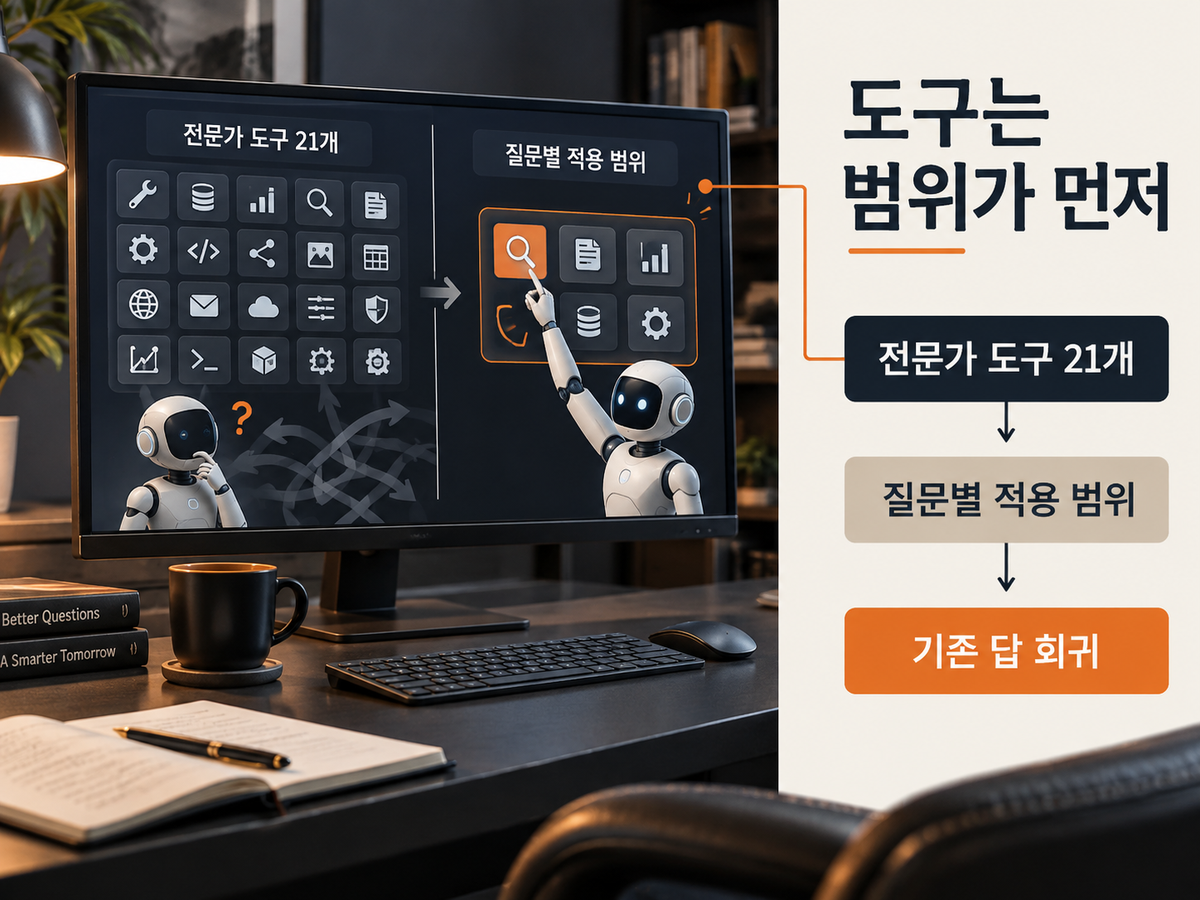
도구 목록이 길어지면 에이전트는 각 질문에서 더 많은 선택지를 마주합니다. 필요한 근거를 계산하는 도구도 있지만, 질문 범위와 맞지 않는 도구가 끼어들면 원래 맞던 추론을 다른 방향으로 밀 수 있습니다.
생활 비유로는 공구함을 통째로 책상 위에 쏟는 장면과 비슷합니다. 망치가 있다는 사실보다, 지금 나사를 조이는 일에 드라이버만 꺼내는지가 더 중요합니다.
논문은 이를 Human–Agent Tool Misalignment라고 부릅니다. 21개 전문가 선별 도구 라이브러리는 일부 과제에서 도움이 됐지만, anomaly 과제에서는 세 백본 모두 5.8~8.8포인트 하락했다고 보고했습니다. 도구의 전문성은 질문별 적합성을 대신하지 못합니다.
평균 점수가 괜찮아도 배포를 멈춰야 하는 순간
업데이트 전후를 평균 정확도 하나로만 보면, 고친 답과 망가진 답이 서로 상쇄됩니다. 그래서 전체 점수가 거의 그대로여도 운영자가 중요하게 여기는 기존 정답이 사라질 수 있습니다.
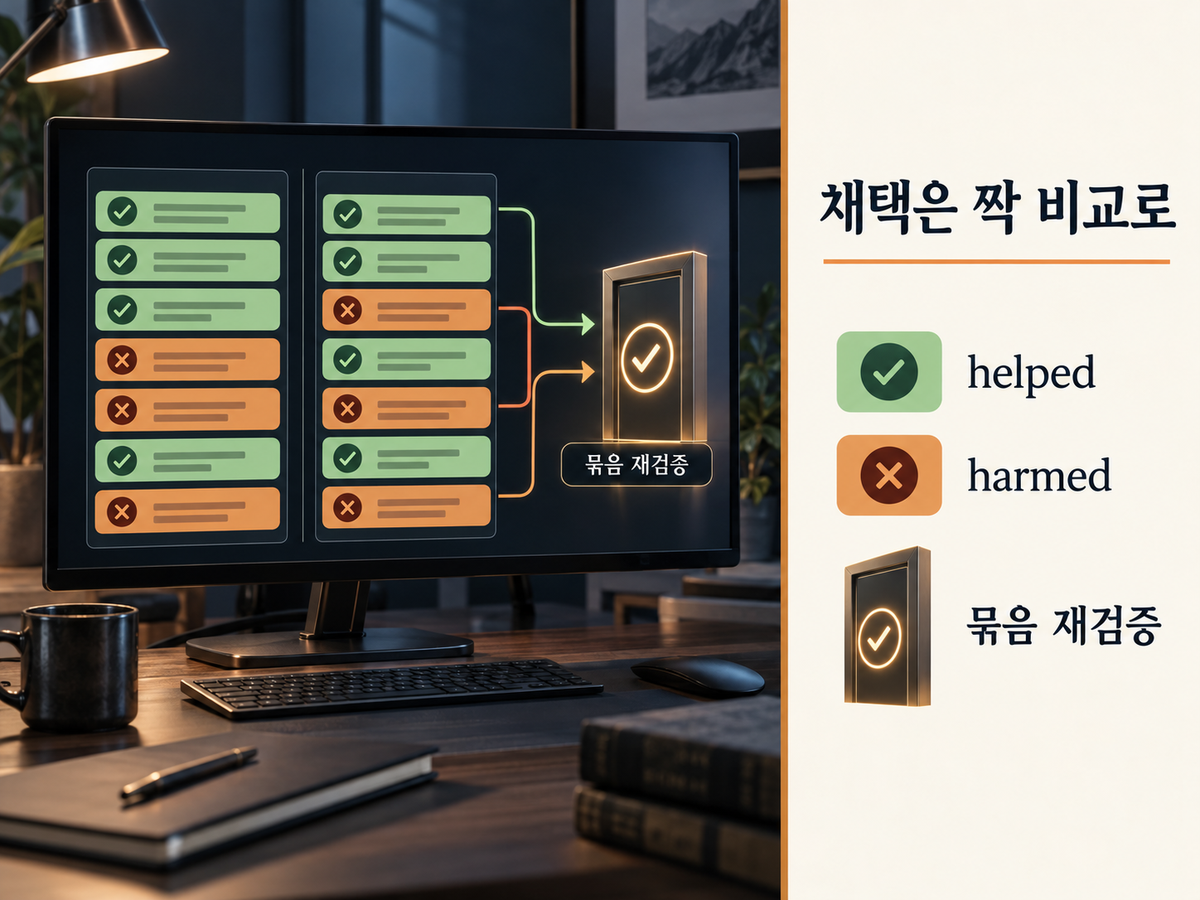
TimeEvo 논문에서 generic Self-Refine 1회는 147개 답을 변경했습니다. 그중 49개는 고쳤지만 56개는 기존 정답을 틀리게 만들었고, 최종 점수 변화는 1포인트 미만이었다고 보고합니다.
작은 검증 표는 이렇게 잡을 수 있습니다.
| 검증 질문마다 기록할 것 | 의미 | 채택 판단에 쓰는 이유 |
|---|---|---|
| helped | 기존 오답 → 새 정답 | 업데이트가 실제로 고친 범위 |
| harmed | 기존 정답 → 새 오답 | 조용히 생긴 회귀 |
| unchanged | 전후 답이 같음 | 변경 효과가 없는 범위 |
평균 상승만으로 통과시키지 말고, helped와 harmed를 같은 질문 집합에서 함께 기록하세요. 특히 예측·이상 탐지처럼 틀린 판단의 비용이 큰 작업이라면 이 구분이 먼저입니다.
TimeEvo는 실패에서 어떤 도구를 만들까요?
TimeEvo는 빈 도구 라이브러리에서 시작해, 학습 분할에서 나온 오답을 실패 묶음으로 나눕니다. 각 묶음에는 정답 규칙이 아니라 필요한 측정 계약(measurement contract)을 정합니다. 원인, 필요한 측정값, 입력, 성공 조건, 적용 범위와 적용 제외 범위가 계약에 들어갑니다.
그 뒤 후보 도구는 숫자 근거만 반환하는 evidence-only 함수로 생성합니다. 판정 문장이나 선택지 문자열을 직접 내놓지 않고, 입력이 없으면 값을 지어내지 않고 abstain해야 합니다.
예를 들어 ‘두 시계열의 동행 여부’를 묻는 질문이 자주 틀린다면 후보의 역할은 “상관·시차 같은 수치를 계산해 반환”하는 데 그칩니다. “A가 정답”이라는 결론을 코드에 박아 넣는 방식은 아닙니다.
입력: 질문 + 매출 시계열 S + 광고비 시계열 C

후보 도구 출력: lag=2에서의 상관, 유효 표본 수, 계산 가능 여부
에이전트: 출력 근거가 있고 범위가 맞을 때만 기존 답을 재검토
도구는 답변기가 아니라, 답을 다시 검토할 수 있게 만드는 측정기여야 합니다. 이 구분이 있으면 데이터셋 전용 상수나 그럴듯한 결론을 후보 함수에 숨기는 일을 줄일 수 있습니다.
채택 게이트는 도구 하나와 묶음 전체를 따로 봅니다
후보 하나가 쓸모없어 보이면 먼저 걸러낼 수 있습니다. 논문은 해당 실패 묶음의 held-out 오류에서 적어도 하나의 ‘실행 기록이 있는 수리’를 보여야 후보가 살아남는 prefilter를 둡니다.
하지만 도구는 함께 설치될 때 간섭할 수 있습니다. 그래서 살아남은 후보 라이브러리를 통째로 기존 라이브러리와 같은 validation 질문에 실행하고, 같은 질문에서 helped와 harmed를 짝지어 비교합니다.
TimeEvo의 엄격한 paired admission은 도움 수가 0보다 크고, 보수적 하한 delta_lb가 0보다 클 때만 통과시킵니다. 한 번만 진화하는 설정에는 별도 보완 규칙도 두지만, 핵심은 같습니다. 작은 이득보다 먼저, 회귀가 이득을 넘어서는지 확인합니다.
운영에 옮길 때의 최소 채택 게이트
논문의 수식을 그대로 복제하지 않아도, 아래 흐름은 팀의 평가 파이프라인에 옮길 수 있습니다.
- 기준 답을 고정합니다. 기존 버전이 맞힌 질문과 틀린 질문을 validation 세트에 남깁니다.
- 후보의 범위를 선언합니다. 어떤 입력·질문에서만 실행할지와 실행하지 않을 anti-scope를 함께 적습니다.
- 수리와 회귀를 함께 셉니다. 후보가 실제로 실행된 경우에만 변경을 귀속하고, 기존 정답이 틀어진 사례를 분리합니다.
- 묶음 설치 후 다시 비교합니다. 단일 도구가 통과해도 조합에서 harm이 늘 수 있습니다.
- 불통과면 현재 버전을 유지합니다. 논문도 rejected round는 라이브러리를 바꾸지 않습니다.
범위 밖 질문은 기존 답을 유지하는 보수적 기본값이 실무에서 특히 유용합니다. 에이전트가 새 근거를 실제로 얻지 못했거나 도구 실행이 실패했을 때, 새 답으로 덮어쓰지 않기 때문입니다.
언제 TimeEvo식 접근이 맞고, 언제 과한가요?
여러 분석 도구를 가진 시계열 QA 에이전트를 운영하고, 새 도구나 프롬프트 수정이 기존 정확도를 해칠 위험이 있다면 잘 맞습니다. 특히 질문별로 도구 적용 범위가 달라지고, 검증 가능한 정답 세트가 있는 팀이라면 paired 비교의 비용을 감당할 이유가 있습니다.
반대로 단일 예측 모델의 오프라인 평가만 하는 단계이거나, 정답이 검증되지 않는 자유서술 업무라면 논문의 게이트를 그대로 적용하기 어렵습니다. 이때도 변경 전후 샘플을 고정하고 회귀 사례를 따로 읽는 습관은 남길 수 있습니다.
논문은 10개 시계열 QA 과제와 3개 백본에서의 결과를 제시합니다. 따라서 특정 회사 데이터, 실시간 스트리밍, 다른 모델 조합에서 같은 폭의 개선이 난다고 볼 수는 없습니다. 저장소도 확인일 기준 Code is coming soon이므로, 지금은 재현 절차보다 평가 설계의 아이디어를 가져오는 단계로 보는 편이 정확합니다.
작업 환경을 함께 정리한다면
아래 카드는 시계열 에이전트의 성능 근거가 아니라, 검증 세트와 실행 기록을 정리하는 책상 환경용 후보입니다. 실제 모델·가격·호환 규격은 카드에서 다시 확인하세요.
검증 질문과 전후 결과를 길게 비교할 때 화면을 넓히는 역할의 후보입니다.
실행 로그와 평가 표를 분리해 보관하는 데 쓸 수 있는 보조 저장 역할의 후보입니다.
이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
출처
- Yang et al., TimeEvo: Failure-Driven Self-Evolution of a Time Series Agent, arXiv:2609.27277v1, 2026-09-23. https://arxiv.org/html/2609.27277v1
- 공식 프로젝트 저장소: https://github.com/Muyiiiii/TimeEvo (확인일 2026-09-29, README:
Code is coming soon)
핵심 정리: 다섯 가지 질문과 답
Q. 전문가가 넣은 도구가 왜 나쁜 결과를 낼 수 있나요?
질문별 적용 범위가 맞지 않는 도구가 기존 추론을 바꾸면, 전문 도구여도 회귀가 생길 수 있습니다.
Q. 평균 정확도만 보면 무엇을 놓치나요?
새로 고친 답과 기존 정답을 망가뜨린 답이 상쇄돼, 실제 회귀가 점수에 잘 드러나지 않을 수 있습니다.
Q. TimeEvo의 후보 도구는 무엇을 반환하나요?
판정이 아니라 시계열에서 계산한 숫자 근거를 반환하며, 입력이 없으면 abstain하는 evidence-only 도구를 지향합니다.
Q. paired admission은 왜 라이브러리 전체를 보나요?
도구 하나씩은 무해해도 함께 설치하면 서로 간섭할 수 있어, 같은 validation 질문에서 묶음으로 helped와 harmed를 비교해야 합니다.
Q. 바로 도입할 수 있는 가장 작은 습관은 무엇인가요?
업데이트 전후의 같은 검증 질문을 고정하고, 기존 정답이 틀어진 사례를 평균 점수와 별도로 기록하는 일입니다.
글을 읽어 주셔서 감사합니다.
이 글이 도움이 되었고 새로운 정보를 계속 받아보고 싶으시다면 구독해 주세요.
'AI > AI 최신 기술' 카테고리의 다른 글
| SciSlopBench, AI 논문이 그럴듯해도 논리 연결을 놓치는 지점 (0) | 2026.10.05 |
|---|---|
| AgentWorld, 에이전트가 오래 같이 일할수록 계획이 무너지는 이유 (0) | 2026.09.29 |
| SLCA-GRPO, 도구 호출은 맞는데 요약 보상에 흔들릴 때 토큰별 책임을 나누는 법 (0) | 2026.09.28 |
| PISA 블록 희소 어텐션, O(N log N)이라 믿기 전 봐야 할 계산 범위 (0) | 2026.09.28 |
| AgentKernel 프롬프트 인젝션, 도구 실행 전에 어디서 끊어야 할까 (0) | 2026.09.27 |


댓글