SLCA-GRPO, 도구 호출은 맞는데 요약 보상에 흔들릴 때 토큰별 책임을 나누는 법
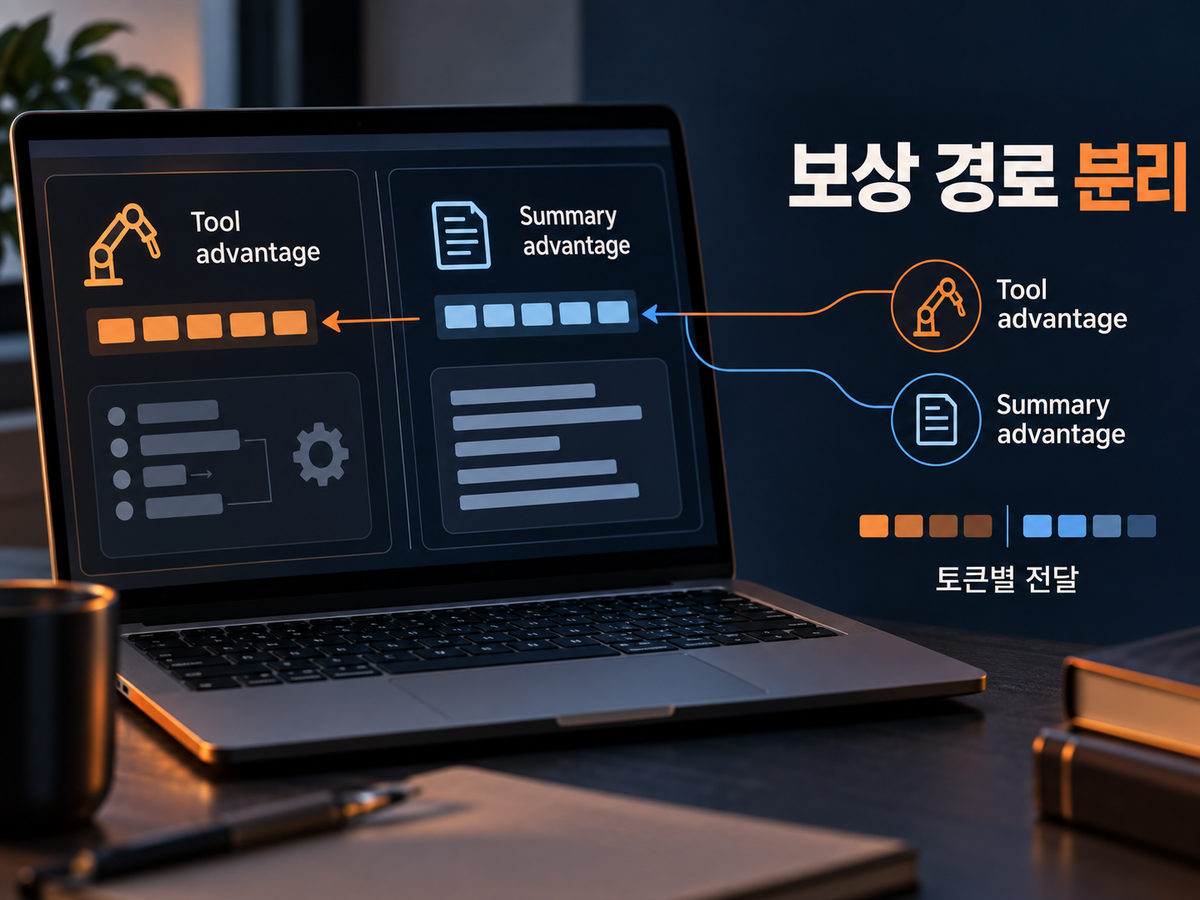
에이전트가 API 이름과 인자를 맞췄는데도 학습이 들쭉날쭉하다면, 마지막 자연어 요약의 보상이 도구 호출 토큰까지 함께 밀고 있을 수 있습니다. SLCA-GRPO는 도구 호출과 최종 요약을 서로 다른 토큰 구간으로 나누고, 각 구간 보상에서 만든 advantage만 해당 토큰에 돌려보냅니다. 도구 행동의 책임을 요약 문장에 떠넘기지 않는 방식입니다.
도구 호출은 주문서 작성이고, 최종 요약은 고객에게 건네는 안내문에 가깝습니다. 주문서는 정확한데 안내문 문체 점수가 흔들린다고 주문서 작성 습관까지 고치면, 학습 신호가 서로 엉킬 수 있습니다.
30초 요약
- GRPO는 한 rollout의 advantage 하나를 모든 학습 토큰에 뿌리는 방식입니다.
- SLCA-GRPO는 tool 구간과 summary 구간의 reward를 각각 group 안에서 정규화합니다.
- tool advantage는 tool 토큰에만, summary advantage는 summary 토큰에만 적용합니다.
- 이 방법은 reward를 둘로 준비해야 하며, 도구 내부의 시간 순서 책임까지 풀어주지는 않습니다.
왜 도구 호출이 맞아도 학습은 흔들릴까?
도구 호출 에이전트의 한 rollout은 보통 구조화된 호출과 사람에게 보여 줄 자유 형식 요약으로 끝납니다. 표준 GRPO에서는 rollout 하나의 상대적 advantage가 계산되면, 그 값이 학습 가능한 토큰 전체에 전달됩니다.
문제는 최종 답변의 선호도나 문체 평가가 좋지 않았을 때입니다. 도구 이름·키·값을 정확히 쓴 앞부분도 같은 불리한 신호를 받습니다.
논문은 이를 cross-segment credit misattribution, 즉 서로 다른 구간 사이의 책임 오배분으로 설명합니다.
핵심은 “응답 전체가 좋았나”와 “도구 호출이 맞았나”가 항상 같은 질문이 아니라는 점입니다. 도구 호출이 이미 정답에 가깝다면, 요약 문장 점수의 차이가 호출 선택까지 거꾸로 흔들 필요는 없습니다.
GRPO와 SLCA-GRPO는 무엇을 다르게 계산할까?
GRPO(Group Relative Policy Optimization)는 같은 프롬프트에서 뽑은 여러 rollout을 한 그룹으로 보고, 그 안의 상대 보상으로 업데이트 신호를 만드는 PPO 계열 변형입니다. 이 설명에서는 수식의 모든 항보다 advantage가 어느 토큰에 붙는가를 보는 편이 빠릅니다.
| 단계 | 표준 GRPO | SLCA-GRPO |
|---|---|---|
| reward 보기 | rollout 전체를 대표하는 하나의 신호 | tool reward와 summary reward를 분리 |
| group 정규화 | 하나의 advantage | 구간별 advantage |
| 토큰 업데이트 | 모든 학습 토큰에 같은 advantage | 각 구간 토큰에 자기 advantage만 적용 |
| 막고 싶은 누수 | 해당 없음 | summary 보상이 tool 토큰으로 가는 경로 |
문서 기반으로 단순화하면 표준 방식은 아래처럼 생각할 수 있습니다.
A_all = normalize(R_all, rollout group)
loss에 붙는 값: tool 토큰 = A_all, summary 토큰 = A_all
SLCA-GRPO는 reward부터 나눕니다. 도구 행동 점수 R_tool과 요약 품질 점수 R_sum을 같은 rollout group 안에서 각각 정규화한 뒤, 갈 곳을 제한합니다.
A_tool = normalize(R_tool, tool 구간이 있는 rollout들)
A_sum  = normalize(R_sum,  summary 구간이 있는 rollout들)

loss에 붙는 값: tool 토큰 = A_tool
loss에 붙는 값: summary 토큰 = A_sum
바뀌는 것은 정책을 둘로 쪼개는 일이 아니라, 토큰에 부착하는 advantage의 경로입니다. 공식 저장소는 이를 하나의 unified policy 안에서, 추가 rollout 비용 없이 처리한다고 설명합니다.
토큰 구간은 누가 나누나?
여기서 새 분류 모델을 붙이면 설계가 무거워질 수 있습니다. 공개 구현은 verl이 이미 유지하는 environment-injection token mask를 이용합니다.
마지막에 연속으로 이어지는 policy-generated 토큰 묶음을 summary segment로 보고, 그보다 앞선 토큰들의 합집합을 tool segment로 봅니다. 즉, 이 구현의 도구 호출 형식처럼 구조적 호출 뒤에 자연어 요약이 오는 패턴에서는 별도의 segmenter를 학습하지 않습니다.
경계가 공짜라는 말은 어떤 출력에도 경계가 있다는 뜻은 아닙니다. 인라인 코드 생성처럼 도구 구조와 자유 텍스트가 뒤섞이면 이 가정은 약해지고, 저장소도 이런 경우 별도 구간화가 필요할 수 있다고 적습니다.
보상은 두 개여야 한다: HierR의 역할
경로만 둘로 나누고 reward가 하나면 분리할 근거가 없습니다. SLCA-GRPO 공개 구현의 HierR(Hierarchical Rewards)은 tool 쪽에 조밀한 process reward를, summary 쪽에 선호도 기반 reward를 둡니다.
도구 reward는 format, tool name, key, value, parallel 항목을 조합합니다. README에 기재된 기본 가중치는 각각 0.10, 0.25, 0.15, 0.20, 0.30입니다.
summary reward는 동결 LLM judge의 5점 평가를 [0,1] 범위로 옮긴 값입니다.
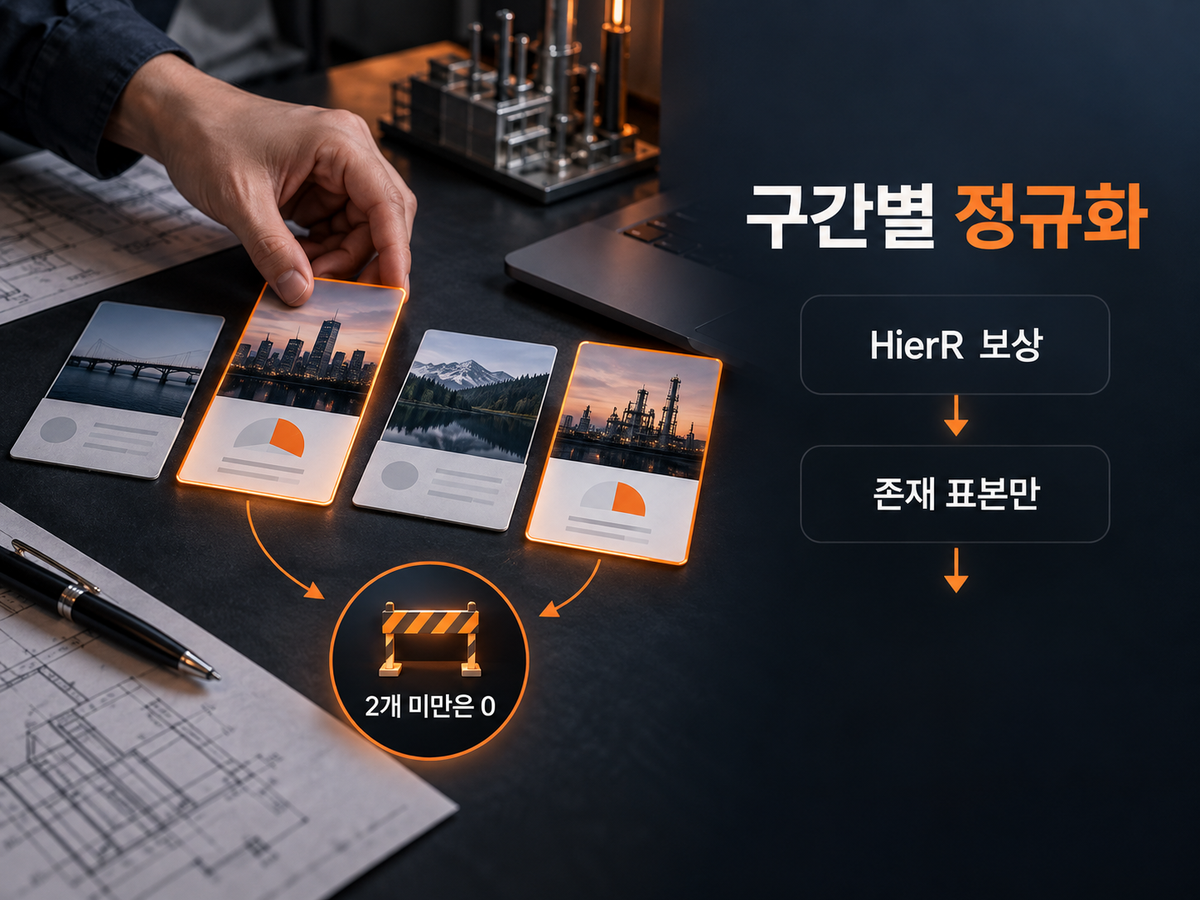
여기서 주의할 점이 하나 있습니다. 구간별 통계는 그 구간이 실제로 있는 rollout만으로 계산합니다.
해당 구간이 있는 표본이 2개보다 적으면 advantage를 0으로 두는데, 원시 reward를 정규화되지 않은 advantage처럼 흘려보내지 않기 위한 보호 장치입니다.
구간이 드문 그룹에서는 억지 정규화보다 업데이트를 건너뛰는 쪽을 택합니다.
작은 입력에서 어떤 신호가 갈리는지 보기
문서 설명을 따라 만든 가상 예시입니다. 실제 저장소의 실행 결과나 벤치마크 수치가 아닙니다.
사용자가 “서울의 전시를 찾아 일정으로 정리해 줘”라고 요청했다고 가정하겠습니다. 에이전트 A와 B 모두 search_exhibition을 올바른 인자로 호출했지만, A는 자연어 요약이 간결하고 B는 중복 설명이 길어 summary judge 점수가 낮습니다.
| rollout | tool process score | summary score | 표준 하나의 신호가 만들 수 있는 일 | SLCA의 처리 |
|---|---|---|---|---|
| A | 높음 | 높음 | tool·summary 모두 유리 | 각 구간이 자기 신호를 받음 |
| B | 높음 | 낮음 | 낮은 요약 점수가 tool 토큰에도 반영될 수 있음 | tool은 높은 process 신호, summary는 낮은 선호 신호 |
이 경우 SLCA는 B의 긴 요약을 개선할 압력은 유지하면서, 이미 맞았던 도구 호출까지 같은 이유로 약화시키지 않으려 합니다. 한 rollout의 실패 이유가 한 가지가 아닐 때, 실패 이유에 맞는 토큰으로만 학습 신호를 보냅니다.
적용 전에 확인할 조건과 한계
SLCA-GRPO는 라이브 API를 바로 붙이는 작은 SDK가 아닙니다. 공개 저장소는 verl 기반 학습 코드와 처리된 데이터 split을 제공하지만, trained checkpoint는 배포하지 않습니다.
SFT, 동결 SGLS simulator, 동결 summary judge, RL 학습이 이어지는 연구용 구성입니다.
공식 README의 재현 경로에는 Python 3.10 환경, vendored verl 0.7.0.dev, vLLM 0.11.0 등이 적혀 있습니다. 다만 저자 실험은 SFT에 8×H20, RL에 32×H20을 사용했다고 명시하므로, 로컬 노트북에서 그대로 재현할 수 있다는 뜻은 아닙니다.
다음 조건이라면 이 방식을 검토할 만합니다.
- 구조화된 tool call과 자연어 최종 답변이 뚜렷이 나뉩니다.
- 도구 호출의 정확도를 별도 process reward로 채점할 수 있습니다.
- summary 품질도 별도 선호 reward로 관리하고 싶습니다.
- rollout group 안에서 각 구간이 충분히 나타납니다.
반대로 도구 호출 안에서 첫 호출은 맞고 두 번째 호출만 틀린 문제에는 한계가 남습니다. SLCA는 tool 구간 전체에 하나의 scalar를 주므로, 도구 토큰 내부의 시간 순서별 책임까지는 나누지 않습니다.
저장소는 VinePPO, GiGPO, SPO처럼 더 세밀한 시간적 credit assignment와의 결합은 아직 검증되지 않았다고 밝힙니다.
시작은 실행보다 CPU 테스트 확인이 낫다
처음부터 대규모 RL을 돌리기보다, 저장소가 제공하는 CPU estimator test로 구간 분리·presence filtering·omission guard가 기대대로인지 확인하는 편이 안전합니다. 공식 README는 다음 테스트를 가장 빠른 확인 경로로 제시합니다.
cd verl
python -m pytest tests/trainer/ppo/test_slca_grpo_on_cpu.py -q
그 다음에야 데이터와 보상 함수를 자신의 도구 스키마에 맞추는 순서가 낫습니다. 특히 tool reward가 정답 경로만 과도하게 칭찬하면, 다른 유효한 도구 계획을 과소평가할 수 있습니다.
실험 수치를 비교할 때는 reward, simulator, judge, backbone, 데이터 분할을 함께 적어야 합니다. 논문이 보고한 7B 결과는 같은 예산·공유 설정에서의 비교이며, 다른 judge나 live API로 바꾸면 reward 분포와 절대 수치도 달라질 수 있습니다.
작업 환경을 함께 정리한다면
재현 준비에서는 장시간 로그 확인과 문서·터미널 병행이 실제로 늘어납니다. 아래 카드는 훈련 성능을 높인다는 도구가 아니라, 각각 화면 작업과 입력 작업을 정리하는 보조 장비로만 골랐습니다.
이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
출처
- SLCA-GRPO 논문: https://arxiv.org/abs/2609.29050
- SLCA-GRPO 공식 코드·재현 문서: https://github.com/SLCA-GRPO/SLCA-GRPO
- SLCA-GRPO 공개 데이터셋: https://huggingface.co/datasets/YanZhanPKU/SLCA-GRPO-Datasets
- GRPO 소개 논문(DeepSeekMath): https://arxiv.org/abs/2402.03300
핵심 정리: 다섯 가지 질문과 답
Q. SLCA-GRPO는 GRPO를 대체하는 별도 정책인가요?
아닙니다. 하나의 정책 안에서 tool·summary 토큰에 부착하는 advantage를 구간별로 분리하는 estimator입니다.
Q. 왜 요약 점수가 도구 호출 학습을 흔들 수 있나요?
표준 GRPO가 rollout 전체의 하나의 advantage를 모든 학습 토큰에 전달하면, 요약 보상 변동도 tool 토큰 업데이트에 섞일 수 있기 때문입니다.
Q. 구간 경계는 새 모델이 찾나요?
공개 구현에서는 verl의 token mask를 이용해 마지막 연속 policy-generated 묶음을 summary로 읽습니다. 출력 형식에 경계가 뚜렷하다는 조건이 필요합니다.
Q. reward를 하나만 두고도 쓸 수 있나요?
구간별로 route할 서로 다른 신호가 필요하므로, 공개 구현은 tool process reward와 summary preference reward를 함께 사용합니다.
Q. 바로 실서비스 API에서 돌려도 되나요?
공개 프로토콜은 SGLS simulator와 동결 judge를 포함한 연구용 구성입니다. 우선 CPU estimator test와 자신의 reward 검증부터 하는 편이 적절합니다.
글을 읽어 주셔서 감사합니다.
이 글이 도움이 되었고 새로운 정보를 계속 받아보고 싶으시다면 구독해 주세요.
'AI > AI 최신 기술' 카테고리의 다른 글
| AgentWorld, 에이전트가 오래 같이 일할수록 계획이 무너지는 이유 (0) | 2026.09.29 |
|---|---|
| TimeEvo, 전문가 도구를 넣기 전 무엇이 깨지는지 보는 채택 게이트 (0) | 2026.09.29 |
| PISA 블록 희소 어텐션, O(N log N)이라 믿기 전 봐야 할 계산 범위 (0) | 2026.09.28 |
| AgentKernel 프롬프트 인젝션, 도구 실행 전에 어디서 끊어야 할까 (0) | 2026.09.27 |
| IterSynth, 검색 기록이 길어질수록 답이 흐릴 때 무엇을 버려야 할까 (0) | 2026.09.27 |


댓글