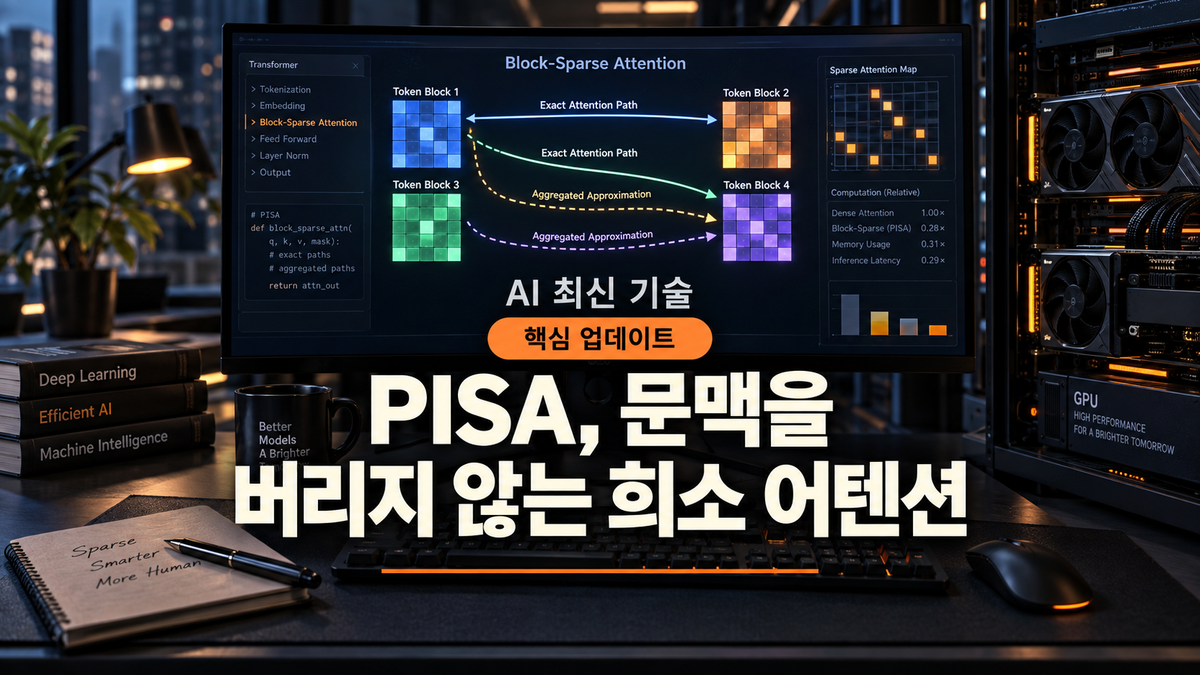
고해상도 영상 생성에서 토큰이 길어지면 GPU는 중요한 장면과 배경을 똑같이 전부 대조하느라 오래 멈춥니다. PISA는 중요한 블록은 정확히 계산하고 나머지는 버리지 않고 근사해, 전체 문맥을 남긴 채 attention 비용을 낮추려는 방식입니다.
PISA의 공식 자료는 모든 상황에서 O(N log N)을 보장한다고 말하지 않습니다.
30초 요약
- PISA(Piecewise Sparse Attention)는 Diffusion Transformer용 training-free attention 방식입니다.
- 선택 K/V 블록은 exact, 비선택 블록은 블록 대표값과 테일러 근사로 계산합니다.
O(N log N)은 후보를 로그 규모로 제한한 별도 라우팅 가정의 직관입니다.- 논문 수치는 H800과 특정 모델·density 조건의 저자 보고치입니다.
PISA는 무엇을 바꾸나
일반 self-attention은 각 Query가 모든 Key와 비교하므로 길이가 N이면 비교쌍이 대략 N²개입니다. FlashAttention은 메모리 이동을 줄여도 이 비교 구조 자체를 없애지는 않습니다.
PISA는 토큰을 연속 블록으로 묶습니다. 책장에서 꼭 읽을 문단은 원문으로 펼치고, 덜 중요한 문단은 요약 카드로 확인하는 식입니다.
핵심은 ‘선택하거나 버리기’가 아니라 ‘정확히 계산하거나 근사하기’입니다.
후보 블록은 어떻게 좁히나
블록마다 Query·Key의 대표값과 Value 합계를 준비한 뒤, Query 블록별 점수로 exact 경로에 둘 K/V 블록 집합을 고릅니다. 논문은 점수뿐 아니라 블록 내부 이질성도 반영하는 covariance-aware Top-k를 제안합니다.
점수가 낮아도 내부 변화가 큰 블록은 근사 오차가 커질 수 있으므로, 선택 단계가 품질의 첫 관문입니다.
| 블록 | 라우팅 결과 | 처리 |
|---|---|---|
| A·B | 중요 | 원래 K·V 토큰으로 exact attention |
| C·D | 비선택 | 블록 평균 Key와 Value 합계로 근사 |
C와 D는 결과에서 사라지지 않습니다. 모든 토큰 쌍을 하나씩 계산하는 대신 블록 단위 집계값을 씁니다.

O(N log N)은 어디서 나오고, 왜 그대로 말하면 안 될까
블록 수를 M=N/B라고 하겠습니다. B가 고정이고 Query 블록마다 exact 후보를 k=O(log M)개만 본다는 별도 설계라면 exact 부분은 M·k·B², 즉 O(N log N) 꼴로 설명할 수 있습니다.
전제는 각 Query가 확인할 원문 블록을 로그 개수로 제한하는 것입니다.
하지만 PISA 논문은 이를 보편적인 점근 보장으로 쓰지 않고 sub-quadratic complexity라고 표현합니다. 비선택 블록도 대표값으로 스캔하며 Top-k 라우팅·블록 크기·density·커널 메모리 접근이 총 시간을 바꿉니다.
따라서 O(N log N)은 후보 제한 전략의 조건부 모델로만 쓰고 PISA 실측 성능과 섞지 않는 편이 정확합니다.
복잡도 표기보다 먼저 볼 값은 시퀀스 길이, exact density, 블록 크기, 목표 GPU입니다.
비선택 블록을 근사해도 softmax가 깨지지 않는 이유
비선택 블록을 마스크로 제거하면 softmax의 분모와 값 집계가 함께 달라집니다. PISA는 선택 블록의 정확한 항과 비선택 블록의 근사 항을 같은 online softmax 누적 흐름에 넣습니다.
블록 평균 Key 중심의 0차 항에 전역 통계 H로 1차 보정을 더합니다. 블록별 큰 행렬을 계속 읽는 메모리 병목을 피하려는 하드웨어 타협입니다.
근사는 ‘계산을 생략한다’가 아니라 낮은 중요도 상호작용을 더 작은 통계로 표현한다는 뜻에 가깝습니다.
문서 기반 최소 사용 흐름
README는 논문 버전 piecewise_sparse_attention_hyd와 학습을 지원하는 단순화 0차 버전 piecewise_sparse_attention_0th를 구분합니다. 아래는 문서 기반 예시이며 이 글에서 실행한 결과는 아닙니다.
from piecewise_attn import piecewise_sparse_attention_hyd
out = piecewise_sparse_attention_hyd(q, k, v, density=0.15, block_size=64)
density=0.15는 exact 경로 비율과 연결됩니다. 가장 낮은 수치를 찾기보다 품질 조건을 통과하는 설정을 찾아야 합니다.
언제 맞고, 언제 멈춰야 하나
PISA는 긴 시퀀스 이미지·영상 Diffusion Transformer에서 full attention이 병목이고, 사전학습 가중치를 크게 바꾸지 않은 채 추론을 줄이고 싶을 때 검토할 수 있습니다. 논문은 Wan2.1, Hunyuan-Video, SD 3.5, FLUX.1을 다뤘고 README는 NVIDIA Hopper(H100/H800) 중심 최적화를 명시합니다.
일반 LLM long-context에 그대로 이식했다고 가정하면 안 됩니다. 토큰 배치, attention sink, causal mask, 지원 GPU가 다르면 라우팅과 정확도 조건도 달라집니다.
공식 실험 대상·GPU·커널 요구사항이 다르면 속도 수치가 아니라 동작 가능성과 dense 출력 차이를 먼저 확인해야 합니다.
논문 초록의 1.91×, 2.57×, 1.2×는 정해진 모델·벤치마크에서의 저자 보고치입니다. 내 모델의 시간표가 아닙니다.

적용 전 짧은 체크
- 대상 모델: DiT 계열인지, PISA용 processor 교체 지점이 있는지 확인합니다.
- 환경: README 기준
torch >= 2.10,triton >= 3.6과 CUDA·GPU 호환성을 점검합니다. - 품질 비교: 동일 seed·입력에서 dense와 출력 차이를 비교합니다.
- 속도 측정: 전체 latency와 attention kernel 시간을 구분합니다.
작업 환경을 함께 정리한다면
논문·코드·profiler를 병렬로 비교할 때 화면 배치를 정리하는 보조 도구입니다. PISA 성능을 높이는 장비가 아닙니다.
코드와 터미널 로그를 오가는 입력 환경의 보조 도구입니다. 호환성·속도는 실제 GPU·커널 조건으로 판단해야 합니다.
이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
출처
- PISA 논문: https://arxiv.org/abs/2602.01077
- PISA 논문 HTML 전문: https://arxiv.org/html/2602.01077v1
- 공식 코드 저장소: https://github.com/xie-lab-ml/piecewise-sparse-attention
핵심 정리: 다섯 가지 질문과 답
Q. PISA는 비선택 문맥을 버리나요?
선택 블록은 exact로 계산하고 비선택 블록은 블록 집계값과 테일러 근사로 반영합니다.
Q. PISA가 항상 O(N log N)인가요?
공식 자료는 보편적 O(N log N) 보장을 명시하지 않습니다.
Q. 왜 전역 1차 보정을 쓰나요?
큰 보정 행렬의 반복 메모리 접근을 줄이기 위해서입니다.
Q. 논문 속도 수치를 내 환경에 적용해도 되나요?
안 됩니다. 모델·H800·density·벤치마크 조건의 저자 보고치입니다.
Q. 첫 검증은 무엇부터 하나요?
동일 입력·seed에서 dense와 PISA 출력 차이, 그리고 전체와 kernel latency를 분리해 비교하세요.
글을 읽어 주셔서 감사합니다.
이 글이 도움이 되었고 새로운 정보를 계속 받아보고 싶으시다면 구독해 주세요.
'AI > AI 최신 기술' 카테고리의 다른 글
| TimeEvo, 전문가 도구를 넣기 전 무엇이 깨지는지 보는 채택 게이트 (0) | 2026.09.29 |
|---|---|
| SLCA-GRPO, 도구 호출은 맞는데 요약 보상에 흔들릴 때 토큰별 책임을 나누는 법 (0) | 2026.09.28 |
| AgentKernel 프롬프트 인젝션, 도구 실행 전에 어디서 끊어야 할까 (0) | 2026.09.27 |
| IterSynth, 검색 기록이 길어질수록 답이 흐릴 때 무엇을 버려야 할까 (0) | 2026.09.27 |
| WanPE 역구성 방식, 한 줄 영상 프롬프트가 샷 계획으로 바뀌는 이유 (0) | 2026.09.26 |


댓글