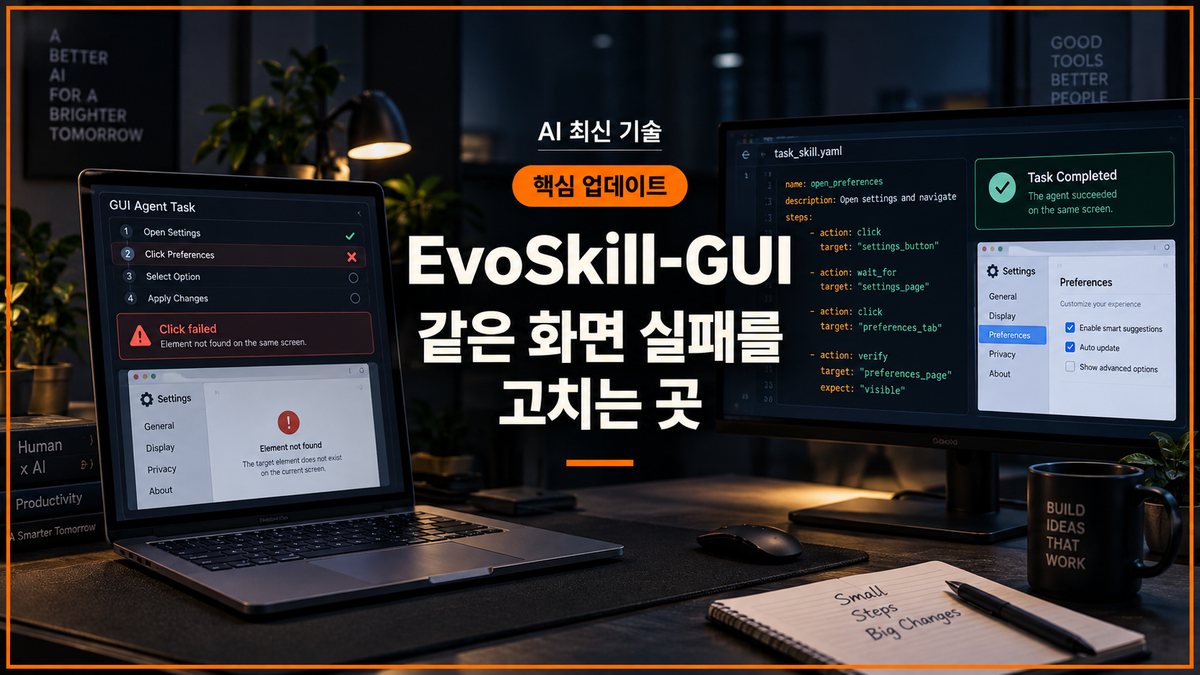
EvoSkill-GUI, 화면 에이전트가 같은 실패를 반복할 때 고치는 곳
화면 에이전트가 팝업 하나에 막혀 같은 클릭을 되풀이한다면, 모델을 다시 훈련하는 것만이 답은 아닙니다. EvoSkill-GUI는 실패 궤적을 읽고 실행 계획·위치 찾기·복구 규칙 중 잘못된 부분만 고쳐 다음 작업에 재사용합니다. 바뀌는 것은 모델 가중치가 아니라 작업 스킬 파일입니다.
30초 요약
- 화면 작업 절차를 한 덩어리 프롬프트가 아닌 역할별 파일로 나눕니다.
- 실행 중 작은 어긋남은 즉시 수정하고, 실패 뒤에는 분리된 비평 과정으로 원인을 찾습니다.
- 고친 스킬은 메타데이터로 검색해 비슷한 작업에 다시 씁니다.
- 논문 성능은 저자 벤치마크 결과이며, 모든 앱에서 향상을 보장하지는 않습니다.
EvoSkill-GUI는 무엇을 고치는 기술인가요?
EvoSkill-GUI는 그래픽 사용자 인터페이스(Graphical User Interface, GUI)를 조작하는 에이전트의 절차 지식을 고칩니다. 버튼을 누르고 입력칸을 채우는 모델 자체가 아니라, 그 모델이 참고하는 작업 설명서를 편집하는 방식입니다.
생활에 빗대면 내비게이션 앱을 새로 만드는 대신 배달 기사님의 업무 매뉴얼을 고치는 쪽에 가깝습니다. 공사 구간에서 길이 막혔다면 ‘목적지까지 직진’이라는 큰 지시를 전부 버리지 않고, 우회로와 확인 지점만 덧붙이는 셈입니다.
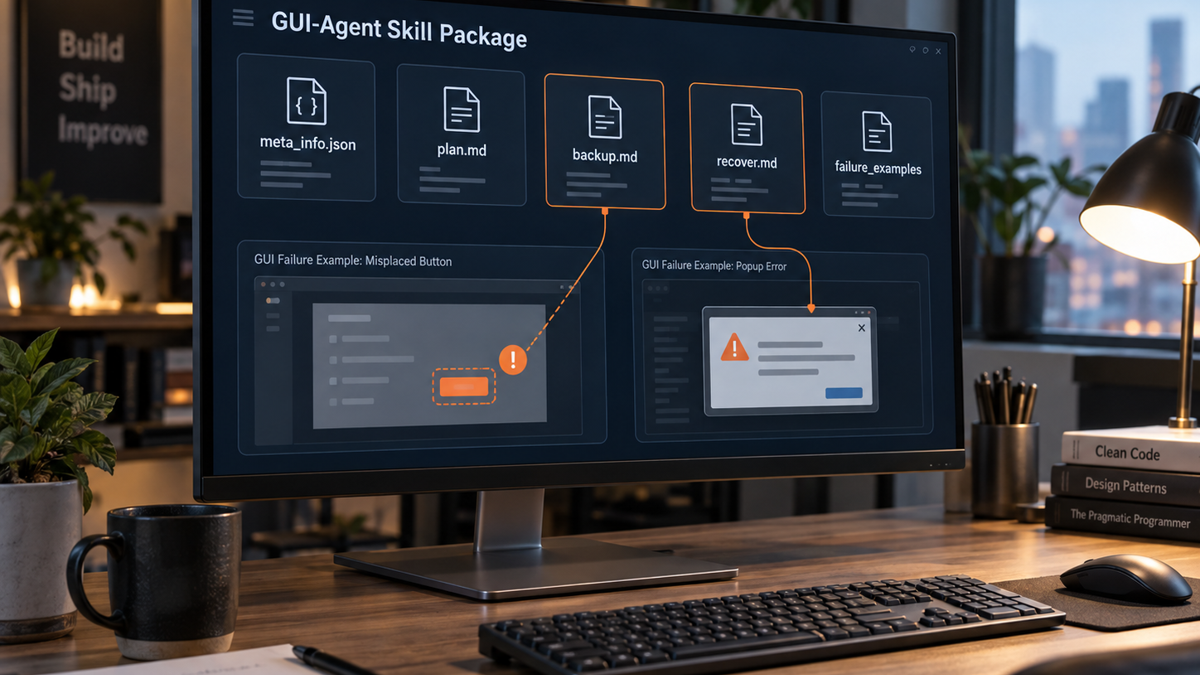
공식 논문은 스킬을 다음처럼 역할별 패키지로 나눕니다.
| 구성 | 맡는 일 | 실패했을 때 고칠 곳 |
|---|---|---|
meta_info.json |
의도·앱·플랫폼·키워드 등 검색 정보 | 엉뚱한 스킬이 검색될 때 |
plan.md |
실행 순서 | 단계가 빠지거나 순서가 잘못됐을 때 |
backup.md |
대체 위치 찾기 | 버튼·입력칸을 못 찾을 때 |
recover.md |
중단·오류 복구 | 팝업이나 예상 밖 화면에 막힐 때 |
failure_examples/ |
실패와 교훈 | 같은 실패를 다음 작업에서 피할 때 |
한 파일에 모든 절차를 몰아넣으면 작은 오류에도 긴 문서를 다시 손봐야 합니다. 역할을 나누면 위치 인식 실패는 backup.md, 빠진 예외 처리는 recover.md처럼 수정 범위를 좁힐 수 있습니다.
실행·비평·수정은 어떤 순서로 이어지나요?
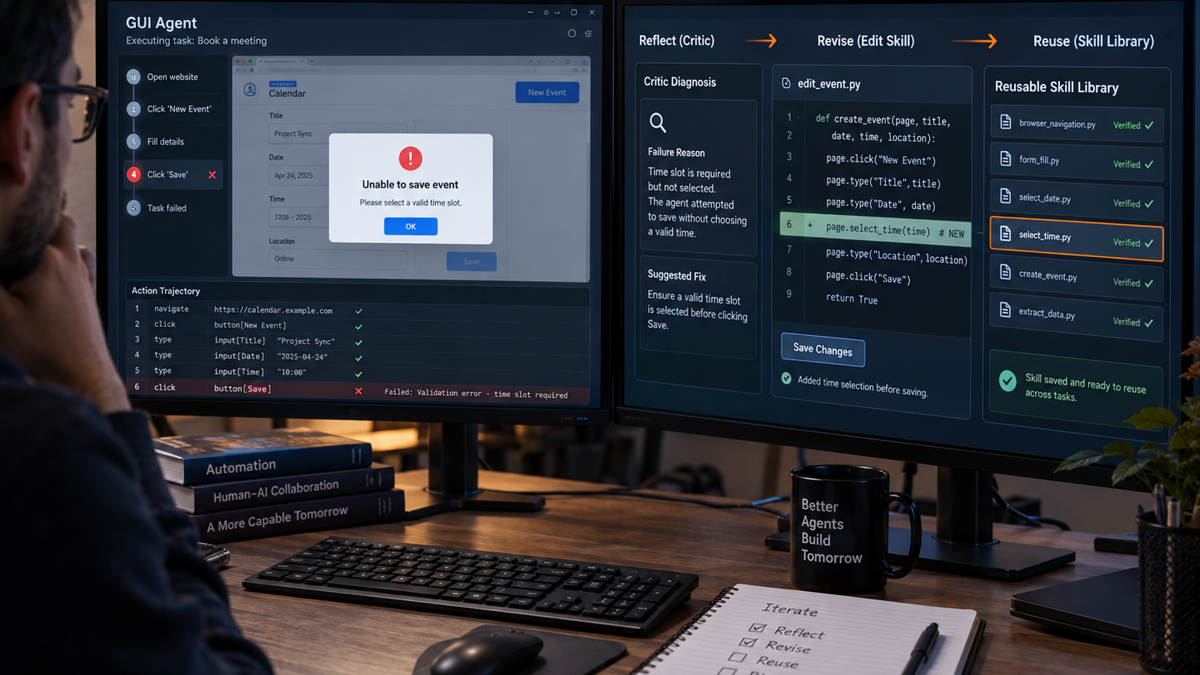
핵심은 reflect–revise–reuse, 즉 돌아보고 고치고 다시 쓰는 순환입니다. 먼저 새 지시와 맞는 스킬을 메타데이터로 찾고, 점수가 기준에 못 미치면 새 패키지를 만듭니다.
에이전트는 화면을 조작하면서 계획과 실제 상태가 어긋나는지 확인합니다. 팝업이나 이동한 위젯처럼 바로 알아챈 문제는 실행 도중 제한된 파일 도구로 국소 수정해 실패가 뒤 단계로 번지는 것을 막습니다.
작업이 끝내 실패하면 같은 기반 모델이 별도 비평 세션에서 궤적을 진단합니다. 이 비평기는 지시, 화면, 접근성 트리, 행동 기록만 보고 스킬 본문이나 정답은 보지 않도록 분리됩니다. 비평기가 더 강한 외부 모델의 정답을 베끼는 구조가 아니라는 점이 설계의 핵심입니다.
진단 결과는 plan.md, backup.md, recover.md 가운데 책임 있는 파일의 수정으로 이어집니다. 검증된 패키지는 라이브러리에 등록되어 관련 작업의 출발점이 됩니다.
실패한 이메일 작업은 어떻게 달라지나요?
공식 저장소가 소개한 사례를 간단한 입력과 출력으로 바꿔보겠습니다. 아래는 직접 실행한 결과가 아니라 논문·README에 근거한 작동 예시입니다.
입력: 지정한 PDF를 찾아 면접 이메일에 첨부해 전송하라
첫 실행: PDF 위치는 찾았지만 열기·검증·첨부 없이 이메일을 전송
진단: 첨부 전 확인 단계가 계획에 빠짐
수정: locate → verify → attach 체크포인트를 plan.md에 추가
다음 실행: 수정된 절차로 재시도
이 예시에서 모델을 미세조정하지 않습니다. 빠진 검증 단계를 계획 파일에 기록해 같은 종류의 다음 작업이 더 나은 절차에서 시작하도록 만듭니다.
장바구니를 끝까지 훑지 않고 중간 합계를 답한 사례에서는 고유 항목 추적과 목록 끝 확인 규칙을 추가했습니다. 두 사례 모두 ‘실패했다’는 한 줄을 저장하는 데서 멈추지 않고, 실패를 다음 행동 규칙으로 바꾼다는 공통점이 있습니다.
훈련이 없다면 정말 학습하지 않는 건가요?
여기서 training-free는 신경망 가중치를 추가로 학습하지 않는다는 뜻입니다. 실행 중 생긴 경험은 사라지지 않고 외부 스킬 패키지와 실패 사례에 남으므로, 넓은 의미에서는 절차 지식이 축적됩니다.
따라서 ‘아무것도 변하지 않는다’와는 다릅니다. 모델 파라미터는 그대로지만, 다음 요청에 주입되는 계획·대체 경로·복구 규칙이 달라집니다.
이 구분은 운영비와 감사 가능성을 볼 때 유용합니다. 어느 실패 때문에 어떤 파일이 바뀌었는지 버전과 편집 로그로 추적할 수 있지만, 잘못된 비평이 규칙으로 굳어질 위험도 함께 관리해야 합니다.
성능 숫자는 어디까지 믿어야 하나요?
2026년 9월 15일 공개된 arXiv v1에서 저자들은 MobileWorld, AndroidWorld, OSWorld를 평가했습니다. 논문 초록이 보고한 최대 절대 향상 폭은 각각 +16.2%p, +6.0%p, +10.5%p입니다.
구조화 패키지와 단일 파일을 비교한 MobileWorld 절제 실험에서는 성공률이 66.67%에서 69.52%로 높아졌습니다. 즉시 수정을 제거하면 62.86%, 비평 정보 격리를 제거하면 60.95%로 내려갔다고 보고합니다.
다만 이것은 저자 실험입니다. 앱별 결과에는 하락한 항목도 있었고, 논문 부록도 간단히 끝날 작업에 스킬 지침이 과하게 붙으면 오히려 복잡해질 수 있다고 짚습니다. ‘훈련 없이 개선’은 ‘어떤 화면에서도 자동 성공’과 같은 말이 아닙니다.
독립 재현이나 실제 서비스 부하를 확인하지 않은 상태에서 지연 시간과 운영비 절감까지 단정할 수는 없습니다. 숫자를 볼 때는 기반 모델, 벤치마크, 작업별 편차를 함께 봐야 합니다.
직접 확인하려면 무엇이 필요한가요?
독립 EvoSkill-GUI 저장소의 현재 README는 Linux 또는 KVM을 켠 WSL2, privileged container를 지원하는 Docker, KVM, Python 3.12, uv를 요구합니다. macOS에서 명령 몇 줄로 바로 시험하는 종류의 예제는 아닙니다.
공식 설치 흐름의 시작은 다음과 같습니다.
git clone --recurse-submodules https://github.com/ZJU-REAL/EvoSkill-GUI.git
cd EvoSkill-GUI
git submodule update --init --recursive
uv sync
uv pip install -e tools/a11y_tree_tool
cp .env.example .env
이어 MobileWorld 환경과 OpenAI 호환 모델 엔드포인트, API 키를 준비해야 합니다. 논문식 실행 옵션에는 최대 50단계, 작업당 최초 실행을 포함한 최대 3회 실행, 검색 임계값 0.6, 접근성 트리 사용이 들어갑니다.
별도로 ClawGUI의 clawgui-skills 모듈은 off, trace, reuse, evolve 네 모드를 문서화합니다. 기본값은 off이며, evolve 모드에서도 활성 스킬 패키지의 계획·대체 경로·복구 규칙·실패 사례만 수정하고 프로젝트 소스코드는 건드리지 않는다고 명시합니다.
이 글에서는 저장소를 설치하거나 벤치마크를 재실행하지 않았습니다. 2026년 9월 20일 확인 당시 GitHub API에는 별도 release와 tag가 없었으므로, 확인되지 않은 안정 버전 번호도 붙이지 않았습니다.
언제 쓰고, 언제는 단순 재시도가 낫나요?
반복되는 긴 화면 작업, 팝업과 지연 로딩이 잦은 앱, 실패 원인을 파일 단위로 감사해야 하는 환경이라면 잘 맞습니다. 비슷한 작업이 계속 들어와 고친 절차를 재사용할 이유가 있을 때 장점이 분명해집니다.
반대로 한두 번만 실행할 간단한 클릭, 실패 비용이 매우 낮은 작업, 잘못된 자동 수정이 큰 피해를 낳는 환경에서는 구조가 과할 수 있습니다. 이런 경우에는 고정된 명시적 워크플로, 단순 재시도, 사람의 승인 체크포인트가 더 낫습니다.
도입을 검토한다면 처음부터 모든 작업에 진화 모드를 켜지 않는 편이 안전합니다. trace로 실패 궤적을 모으고, reuse로 기존 스킬의 가치부터 확인한 뒤, 수정 가능한 파일과 승인 조건을 정해 evolve를 좁게 적용하는 순서가 현실적입니다. 자동 수정 범위와 되돌리기 기준을 먼저 정해야 합니다.
작업 환경을 함께 정리한다면
실행 화면과 실패 궤적을 나란히 확인할 때는 휴대용 모니터가 작업 창을 분리하는 데 쓰입니다. 아래 제품은 실제 쿠팡 파트너스 검색에서 확인했지만, 연결 단자와 사용 중인 노트북의 영상 출력 호환 여부는 상품 페이지에서 다시 확인해야 합니다.
노트북 거치대는 긴 검증 작업에서 화면 높이와 입력 위치를 조절하는 준비 도구입니다. 접이식·높이 조절 제품을 골랐으며, 노트북 크기와 무게를 견디는지는 구매 전에 상품 상세 규격과 맞춰보는 편이 안전합니다.
이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
출처
- EvoSkill-GUI 원 논문, arXiv:2609.17653v1: https://arxiv.org/html/2609.17653v1
- EvoSkill-GUI 공식 저장소: https://github.com/ZJU-REAL/EvoSkill-GUI
- ClawGUI-Skills 공식 문서: https://github.com/ZJU-REAL/ClawGUI/tree/master/clawgui-skills
핵심 정리: 다섯 가지 질문과 답
Q. EvoSkill-GUI는 모델을 다시 훈련하나요?
아닙니다. 모델 가중치 대신 외부의 구조화된 스킬 파일을 실행 피드백으로 수정합니다.
Q. 실패하면 어느 부분을 고치나요?
실행 순서는 plan.md, 대체 위치 찾기는 backup.md, 예외 복구는 recover.md처럼 원인에 맞는 파일을 고칩니다.
Q. 같은 모델이 자기 실패를 평가해도 되나요?
논문은 실행 세션과 비평 세션을 나누고, 비평기가 스킬 본문·추론 과정·정답을 보지 못하게 정보 범위를 제한합니다.
Q. 모든 GUI 작업에서 성능이 좋아지나요?
아닙니다. 저자 실험의 전체 성과와 별개로 일부 앱별 결과는 나빠졌으며, 단순 작업에는 스킬 지침이 방해가 될 수 있습니다.
Q. 바로 설치해 시험하기 쉬운가요?
공식 독립 저장소 기준으로 Docker·KVM·Python 3.12·MobileWorld 환경과 모델 엔드포인트가 필요합니다. 요구 환경을 먼저 확인해야 합니다.
'AI > AI 최신 기술' 카테고리의 다른 글
| RecreationWorld, 화면만 닮은 AI 앱을 멈추게 하는 동작 검증 (0) | 2026.09.21 |
|---|---|
| EvoOntology, 컬럼명만 보고 헤매는 데이터 에이전트를 어떻게 멈추나 (0) | 2026.09.21 |
| When2Think, 쉬운 질문까지 길게 답하는 AI를 어떻게 멈출까 (0) | 2026.09.20 |
| WeVisDoc 평가, 표 점수만 보면 놓치는 것 (1) | 2026.09.19 |
| Claude Code 세션 협업, 뭘 써야 할까 (1) | 2026.09.15 |


댓글