RecreationWorld, 화면만 닮은 AI 앱을 멈추게 하는 동작 검증
AI에게 “이 앱을 똑같이 만들어줘”라고 했는데 버튼을 누르면 아무 일도 안 일어나는 경우가 있습니다. RecreationWorld는 화면 캡처의 닮은 정도보다 사용자가 실제로 관찰하는 동작을 기준으로 후보 앱을 검증하려는 프레임워크입니다. 즉, 예쁜 복제본을 끝내는 도구라기보다 탐색·구현·실행 확인을 한 루프로 묶는 벤치마크 환경에 가깝습니다.
30초 요약
- 참조 앱을 실행 가능한 기준점으로 삼습니다.
- 에이전트는 GUI 탐색, 코드 구현, 실행 결과 확인을 오갑니다.
- 최종 평가는 소스 코드 모양이 아니라 프로그램·시각 assertion으로 확인합니다.
- 공식 README 기준 5개 플랫폼에 250개 held-out task가 있습니다.
화면 복제는 왜 버튼 검증까지 못 갈까요?
스크린샷은 결과 화면 한 장을 보여줄 뿐입니다. 탭을 눌렀을 때 화면이 바뀌는지, 입력이 저장되는지, 잘못된 값을 만났을 때 어떤 상태가 되는지는 그 한 장에 남지 않습니다.
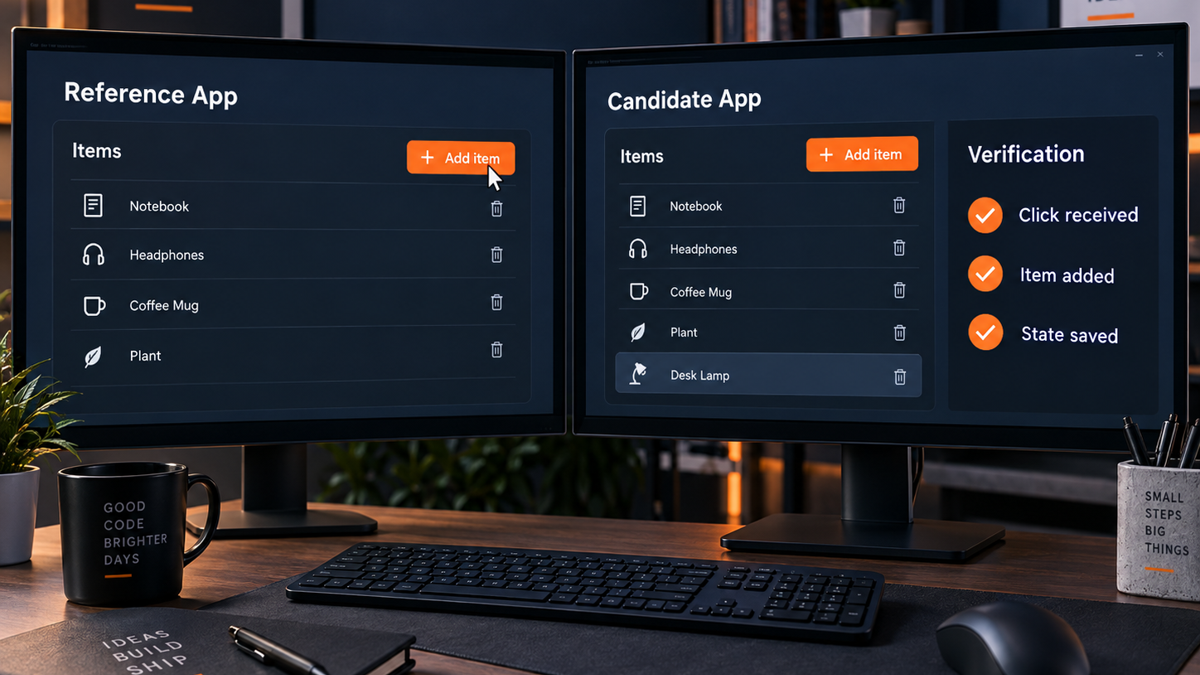
예를 들어 할 일 앱의 카드와 색은 비슷하게 만들 수 있어도, 완료를 눌렀을 때 항목이 이동하고 새로고침 뒤에도 상태가 남는지는 별도 확인이 필요합니다. 보이는 결과와 눌렀을 때의 결과는 다른 테스트 대상입니다.
| 확인 방식 | 잘 잡는 것 | 놓치기 쉬운 것 |
|---|---|---|
| 화면 비교 | 배치, 색, 텍스트, 아이콘 | 저장·전환·오류 처리 |
| 동작 assertion | 클릭 후 상태, 입력값, 결과 | 시각적 완성도 일부 |
| 둘을 함께 사용 | 기능과 사용자가 보는 결과 | 참조 범위 밖 품질 |
RecreationWorld는 무엇을 기준으로 삼나요?
QwenLM의 공식 README는 RecreationWorld를 하이브리드 컴퓨터 사용 에이전트를 위한 프레임워크로 소개합니다. 에이전트가 GUI를 탐색하고, 코딩 도구로 구현하고, 자기 실행 결과를 시각적으로 확인하는 일을 섞어 수행한다는 설명입니다.
핵심은 실행 중인 참조 앱을 실행 가능한 오라클로 둔다는 점입니다. 오라클은 정답을 외워 둔 파일이 아니라, “이 조작을 했을 때 이 상태가 나와야 한다”를 관찰할 기준점이라고 생각하면 됩니다. 냉장고 사진을 보고 문 손잡이 위치를 그리는 것과, 문을 열어 실제로 선반이 움직이는지 확인하는 일의 차이와 비슷합니다.
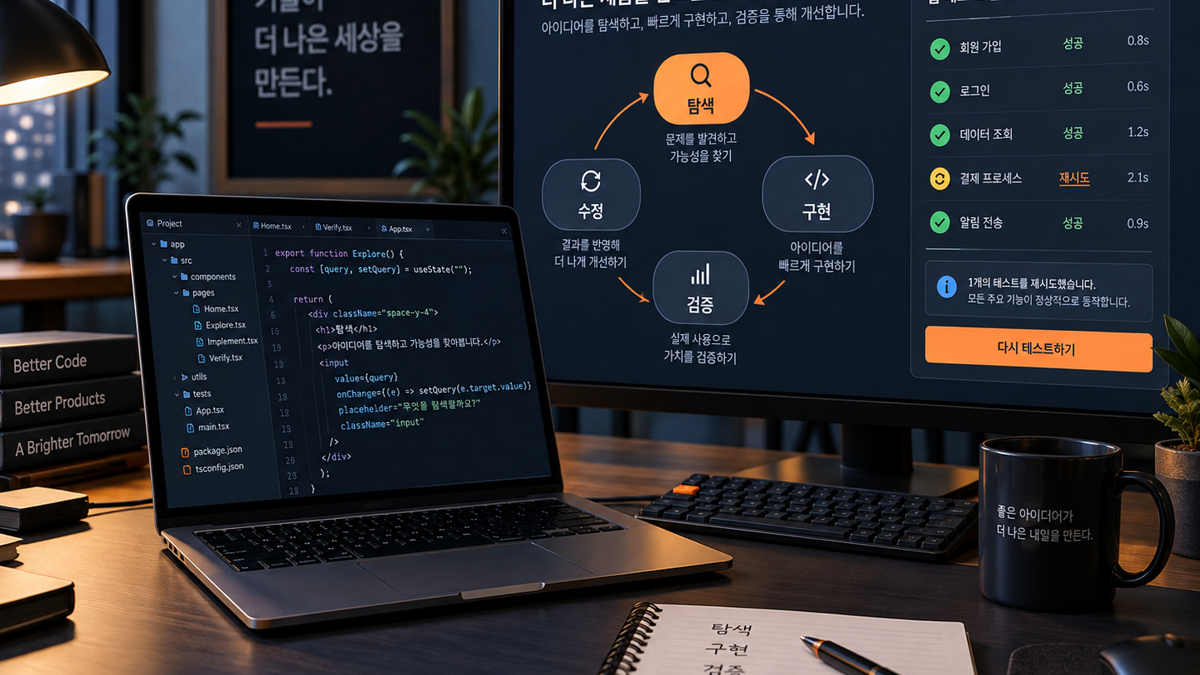
문서가 설명하는 흐름은 고정된 순서가 아닙니다. 에이전트는 필요한 때 참조 앱을 살피고, 후보 앱을 고치고, 빌드·실행 뒤 다시 확인합니다. 탐색 → 구현 → 검증 → 수정이 한 번의 반복 루프가 됩니다.
요청: "새 항목을 추가하고 완료 처리할 수 있는 목록 화면"

참조 앱 탐색
  → 입력 후 추가 버튼의 결과 관찰
  → 후보 앱 구현·실행
  → "추가됨"과 "완료 상태 전환" assertion 확인
  → 실패한 동작만 다시 구현
이 예시는 README의 원리를 풀어 쓴 문서 기반 예시이며, 이 글에서 벤치마크를 실행한 기록은 아닙니다.
무엇을 어떻게 점수로 확인하나요?
RecreationBench는 공식 README 기준으로 5개 플랫폼에서 각각 50개, 합계 250개의 held-out task를 둡니다. Ubuntu(AT-SPI), macOS(AXUIElement), Windows(UI Automation), Android(UiAutomator), Web(브라우저 assertion) 구성이며, 환경마다 UI 접근 방식이 다릅니다.
최종 후보는 참조 앱을 바탕으로 검증된 고정 프로그램 assertion과 시각 assertion으로 평가합니다. 소스 코드가 얼마나 닮았는지가 아니라 관찰 가능한 동작이 점수의 중심이므로, 프레임워크나 내부 구조는 달라도 됩니다.
이 기준에는 분명한 장점이 있습니다. React인지 다른 프레임워크인지보다 “사용자가 입력하고 누른 뒤 기대한 상태를 받는가”를 확인할 수 있기 때문입니다. 반대로 assertion이 정의하지 않은 접근성, 보안, 성능, 장기 유지보수까지 자동으로 보장하는 것은 아닙니다.
문서대로 시작할 때, 어디까지가 최소 실행인가요?
공식 Quickstart는 저장소 루트에서 아래 두 명령을 제시합니다.
uv sync
uv run rb run --help
첫 명령은 의존성을 맞추고, 두 번째는 실행 명령의 도움말을 확인하는 출발점입니다. 다만 점수화된 실행에는 해당하는 frozen task bundle, 준비된 실행 환경, 모델 endpoint와 judge endpoint가 추가로 필요하다고 README가 명시합니다. 도움말 확인과 채점 실행은 요구 조건이 다릅니다.
체크아웃 자체는 문서가 제시한 오프라인 smoke check로 먼저 점검할 수 있습니다.
uv run python scripts/release/smoke_providers.py
uv run python scripts/release/smoke_runtime.py
여기서 통과해도 특정 모델의 벤치마크 점수를 재현했다는 뜻은 아닙니다. provider와 runtime의 기본 점검이 먼저이고, 그다음에 task bundle과 endpoint를 갖춘 평가 환경을 준비하는 순서가 안전합니다.
이런 팀에는 맞고, 이런 일에는 과합니다
이미지 생성 결과가 아니라 실제 인터랙션까지 재현해야 하는 컴퓨터 사용 에이전트 연구·평가에 잘 맞습니다. 특히 여러 운영체제나 웹·모바일을 걸쳐 “보이는 모양”과 “누르면 일어나는 일”을 함께 확인해야 할 때 기준을 세우기 좋습니다.
반면 단일 정적 랜딩 페이지를 빠르게 시안으로 만들거나, 제품 수준의 보안·성능 시험을 하려는 경우에는 이것만으로 충분하지 않습니다. 후자의 경우 별도의 E2E 테스트, 접근성 점검, 보안 검토를 목적에 맞게 붙여야 합니다.
실무에서는 먼저 참조 앱에서 반드시 유지할 사용자 행동을 3~5개로 작게 적어두는 편이 낫습니다. “저장 버튼이 있다”보다 “저장 후 새로 열어도 제목이 남는다”처럼 관찰 가능한 결과로 쓰면 assertion 설계도 덜 흔들립니다.
지금 확인할 한 가지
RecreationWorld의 공개 저장소는 2026-09-18에 생성된 것으로 확인했고, 확인 시점에 GitHub Release와 태그는 없었습니다. 2026-09-21의 최근 커밋은 update arxiv 병합이므로 이를 정식 릴리스로 읽으면 안 됩니다.
프로젝트를 도입하기 전에는 README의 플랫폼별 가이드와 tasks/의 canonical index를 함께 살펴보세요. 내 작업의 필수 행동을 assertion으로 표현할 수 있는지부터 확인하면, 화면만 그럴듯한 복제본에 시간을 쓰는 일을 줄일 수 있습니다.
작업 환경을 함께 정리한다면
반복 검증을 할 때 화면·입력 장치를 정돈하는 핵심 실행 역할의 후보입니다. 실제 모델명·규격·호환성은 카드에서 직접 확인해야 합니다.
테스트 시나리오와 관찰 결과를 나란히 두는 측정·기록 역할의 후보입니다. 역시 카드에 표시된 조건을 확인한 뒤 선택하세요.
이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
출처
- QwenLM/RecreationWorld 공식 GitHub README — 워크플로, 플랫폼, 평가, Quickstart 확인
- GitHub repository metadata — 저장소 생성일 확인
- GitHub tags API 및 releases API — 확인 시점의 태그·Release 상태 확인
핵심 정리: 다섯 가지 질문과 답
Q. RecreationWorld는 화면 비교 도구인가요?
아닙니다. 화면 확인도 쓰지만, 참조 기반 프로그램·시각 assertion으로 관찰 가능한 동작을 함께 평가합니다.
Q. 왜 실행 중인 참조 앱이 필요한가요?
사용자 조작 뒤 어떤 상태가 나와야 하는지 관찰할 기준점이 되기 때문입니다.
Q. 후보 앱의 소스 구조가 참조와 같아야 하나요?
공식 README 설명상 소스 수준 유사성이 아니라 관찰 가능한 동작이 점수 기준이므로, 구현 언어·프레임워크·구조는 달라도 됩니다.
Q. uv sync만 하면 바로 벤치마크 점수가 나오나요?
아닙니다. 점수 실행에는 frozen task bundle, 실행 환경, 모델 및 judge endpoint가 추가로 필요합니다.
Q. 이 프레임워크만으로 제품 품질을 보장할 수 있나요?
아닙니다. assertion 범위 밖의 보안·성능·접근성·유지보수는 별도 검증이 필요합니다.
'AI > AI 최신 기술' 카테고리의 다른 글
| JitMem, 에이전트 메모리를 저장할 때 요약하면 놓치는 단서 (0) | 2026.09.25 |
|---|---|
| GameHorizon 장기 행동 평가, 짧은 점수로 에이전트를 믿으면 놓치는 것 (0) | 2026.09.22 |
| EvoOntology, 컬럼명만 보고 헤매는 데이터 에이전트를 어떻게 멈추나 (0) | 2026.09.21 |
| EvoSkill-GUI, 화면 에이전트가 같은 실패를 반복할 때 고치는 곳 (0) | 2026.09.20 |
| When2Think, 쉬운 질문까지 길게 답하는 AI를 어떻게 멈출까 (0) | 2026.09.20 |


댓글