WeVisDoc 평가, 표 점수만 보면 놓치는 것
WeVisDoc의 문서 파싱 성능을 볼 때 Overall 하나만 확인하면 부족합니다. 표의 셀 구조, 페이지 읽기 순서, 스캔·촬영 열화 성능을 따로 보고 실제 업무 문서에서 치명적인 오류를 세어야 도입 여부를 판단할 수 있습니다. 특히 병합 셀과 다단 편집은 글자 몇 개가 맞는 것보다 관계가 보존됐는지가 더 중요합니다.
30초 요약
- WeVisDoc은 페이지 이미지를 Markdown·LaTeX·HTML 표로 바꾸는 2B·4B 문서 파서입니다.
- 저자 보고 기준 4B의 OmniDocBench v1.6 Overall은 95.38이지만, 이 수치를 실무 정확도로 읽으면 안 됩니다.
- 표는 TEDS와 함께 병합 셀·빈 셀·행·열 관계를 직접 검사해야 합니다.
- 복잡한 레이아웃은 읽기 순서와 캡션 연결을 별도 항목으로 봐야 합니다.
- 깨끗한 PDF와 스캔·휴대폰 촬영본은 같은 평균에 섞지 않는 편이 안전합니다.
WeVisDoc은 OCR과 무엇이 다른가요?
일반 OCR이 글자를 읽는 데 초점을 둔다면, 문서 파싱은 글자와 구조를 함께 복원합니다. WeVisDoc은 페이지 이미지 한 장을 받아 본문은 Markdown, 수식은 LaTeX, 표는 HTML로 직렬화하는 종단간(end-to-end) 파서입니다.
공식 저장소는 Qwen3-VL-2B-Instruct와 Qwen3-VL-4B-Instruct를 미세 조정한 2B·4B 체크포인트를 제공합니다. 논문 v1 공개일은 2026년 9월 17일이며, Hugging Face 모델 카드는 Apache-2.0 라이선스와 BF16 Safetensors를 표시합니다.
이삿짐으로 비유하면 조금 선명해집니다. OCR이 상자에 적힌 글자를 읽는 일이라면, 문서 파싱은 어느 상자가 어느 방으로 가고 무엇과 한 묶음인지까지 되살리는 일입니다. 글자는 맞아도 배치 관계가 틀리면 표 질의나 검색 증강 생성(RAG)에서 엉뚱한 답이 나올 수 있습니다.
Overall 95.38만 보고 도입해도 될까요?
아닙니다. 공식 README가 보고한 WeVisDoc-4B의 OmniDocBench v1.6 결과는 Overall 95.38이며, 세 번의 추론 평균입니다. 같은 표에서 TextEdit은 0.036, FormulaCDM은 96.81, TableTEDS는 92.95, 읽기 순서 ROEdit은 0.125로 제시됩니다.
OmniDocBench의 Overall은 텍스트 편집거리, 표 TEDS, 수식 CDM을 결합한 값입니다. 읽기 순서 ROEdit은 별도 열이고 Overall 계산식에 직접 들어가지 않습니다. 그러니 Overall이 높다는 사실만으로 다단 문서의 순서까지 잘 복원한다고 결론 내릴 수 없습니다.
또 하나의 함정은 백분율처럼 읽는 것입니다. 95.38은 해당 벤치마크의 정의와 데이터 구성에서 나온 종합 점수이지, 회사 문서 100개 중 95개가 완벽하게 처리된다는 뜻이 아닙니다.
| 확인 항목 | 공개 지표 | 실무에서 함께 볼 것 |
|---|---|---|
| 본문 문자 | TextEdit | 숫자·고유명사·단위 오류 |
| 표 | TableTEDS, TableTEDS_S | 병합 셀, 빈 셀, 헤더-값 관계 |
| 수식 | FormulaCDM | 렌더링과 의미 보존 |
| 페이지 흐름 | ROEdit | 열 전환, 캡션, 각주 순서 |
표는 글자가 아니라 관계를 평가해야 합니다
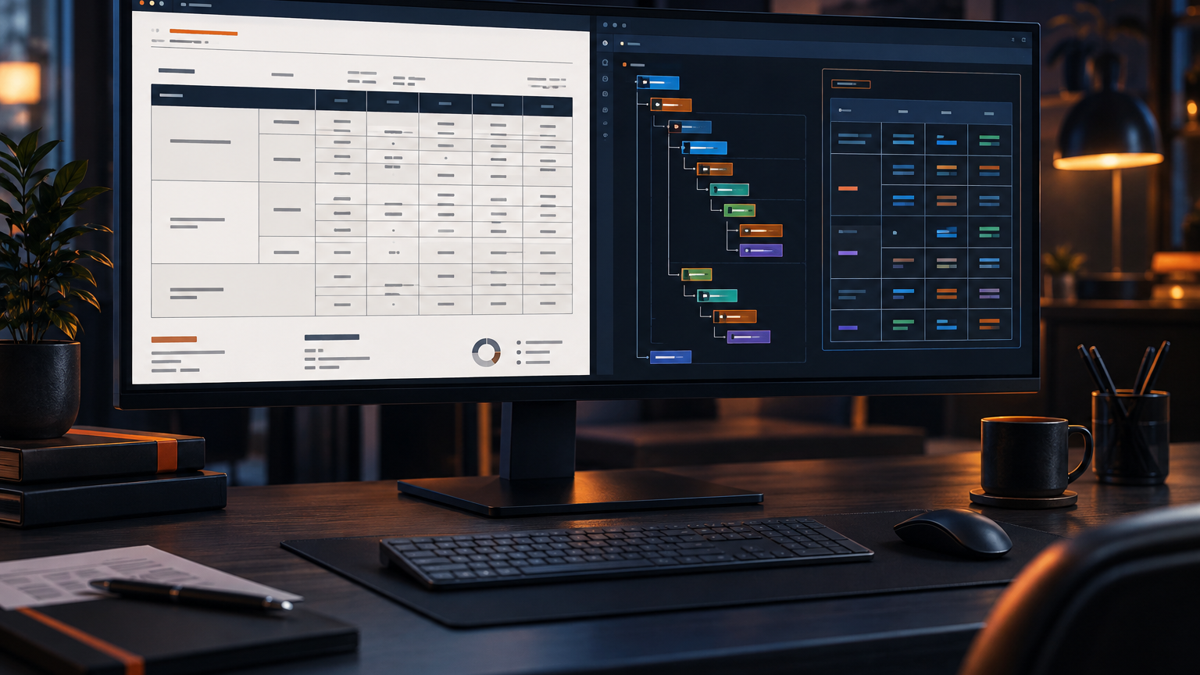
Tree-Edit-Distance-based Similarity(TEDS)는 예측 HTML과 정답 HTML의 트리 구조와 셀 내용을 비교합니다. 표를 평평한 문자열로 바꿔 편집거리만 재면 행과 열이 뒤바뀌어도 글자가 남아 있어 점수가 그럴듯하게 보일 수 있는데, TEDS는 이 약점을 줄이는 지표입니다.
다만 TEDS 하나로 업무 적합성이 끝나지는 않습니다. 가격표에서 상품과 금액이 한 칸 어긋나는 오류, 재무표에서 연도 헤더가 밀리는 오류처럼 문자 수는 적어도 업무 영향이 큰 실패를 별도로 세어야 합니다.
OmniDocBench의 표 속성은 병합 셀, 테두리 유무, 가로·세로 방향, 수식 포함, 배경색, 회전 여부를 구분합니다. 자체 평가 세트도 같은 방식으로 난도를 나누면 “표 평균은 높지만 무선 표와 병합 셀에서 무너지는” 상황을 발견하기 쉽습니다.
작은 예를 보겠습니다. 아래는 실제 실행 결과가 아니라 평가 방식을 설명하기 위한 문서 기반 예시입니다.
입력 표가 다음과 같다고 가정합니다.
| 분기 | 국내 | 해외 |
|---|---|---|
| 1분기 | 120 | 80 |
| 2분기 | 140 | 95 |
문자만 비교하면 120, 80, 140, 95가 모두 들어간 출력은 좋아 보입니다. 하지만 HTML에서 120과 80의 열이 바뀌면 “해외 1분기 120”이라는 잘못된 관계가 만들어집니다. 이 경우에는 셀 텍스트 일치와 함께 행·열 위치, rowspan·colspan, 빈 셀 보존을 확인해야 합니다.
복잡한 레이아웃은 읽기 순서에서 티가 납니다
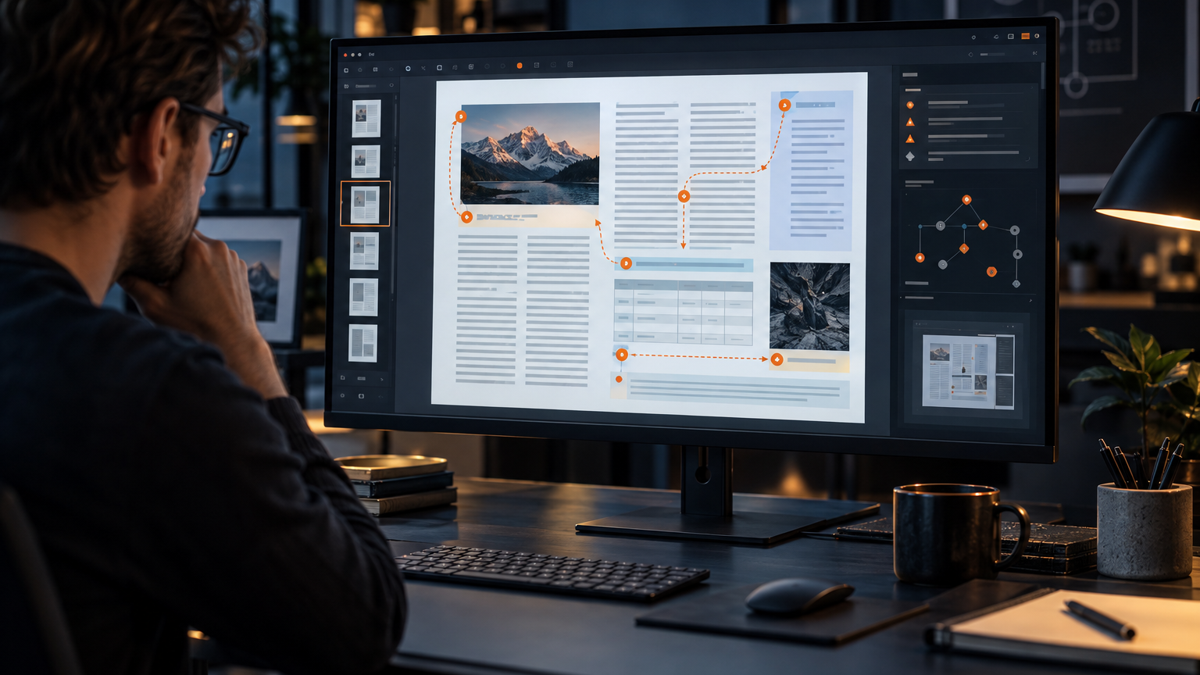
다단 논문, 신문, 슬라이드, 양식은 위에서 아래로만 읽지 않습니다. 왼쪽 열을 끝낸 뒤 오른쪽 열로 넘어가야 하고, 표·그림 캡션은 대응 요소와 붙어야 하며, 각주는 본문 중간에 끼어들면 안 됩니다.
WeVisDoc 논문도 문서 파싱을 텍스트, 요소 유형, 구조 조직, 읽기 순서의 보존 문제로 정의합니다. 학습 범위에는 단일·다단 페이지, 사이드바, 떠 있는 요소, 각주, 양식처럼 고정된 위→아래 규칙으로 풀기 어려운 구성이 포함됐다고 설명합니다.
실무 검수에서는 결과 Markdown을 눈으로 읽는 것만으로 부족합니다. 블록마다 정답 순번을 붙인 뒤 예측 순서를 비교하고, 다음 오류를 따로 기록하는 편이 낫습니다.
- 열을 건너뛰거나 같은 블록을 두 번 읽었는가
- 제목·본문·목록의 계층이 유지됐는가
- 표·그림과 캡션이 붙어 있는가
- 머리말·꼬리말이 본문으로 섞였는가
- 각주와 본문의 위치 관계가 깨졌는가
깨끗한 PDF만 통과하면 충분할까요?
운영 입력에 스캔이나 휴대폰 사진이 있다면 충분하지 않습니다. PureDocBench는 같은 소스에서 깨끗한 페이지, 디지털 열화본, 실제 촬영·재현 열화본을 만들어 조건별 차이를 비교합니다. WeVisDoc 공식 보고에서도 4B의 세 트랙 Overall은 Clean 79.81, Digital Degraded 77.74, Real Degraded 69.08로 서로 다릅니다.
세 값을 한 평균에 묶으면 운영 환경의 약점이 가려집니다. 깨끗한 PDF, 저해상도 스캔, 원근이 생긴 휴대폰 사진, 화면 재촬영본을 따로 묶고 실패율을 비교해야 실제 유입 분포에 가까운 결정을 내릴 수 있습니다.
저자들은 Stage I에서 넓은 문서·구조·외관 범위를 학습하고, Stage II에서 남은 오류 군집을 진단해 데이터를 보강하는 접근을 설명합니다. 프로젝트 페이지에는 누락됐던 9×9 스도쿠 표를 Stage II가 복원한 선택 사례도 있지만, 저자가 고른 사례이므로 전체 성능의 보증처럼 받아들이지는 않는 편이 정확합니다.
20~30페이지로 자체 평가를 시작하는 순서
처음부터 거대한 벤치마크를 만들 필요는 없습니다. 실제 업무에서 자주 들어오는 문서와 실패하면 곤란한 문서를 섞어 20~30페이지로 시작해도 모델 선택의 방향은 잡을 수 있습니다.
- 입력을 깨끗한 PDF, 스캔, 촬영본으로 나눕니다.
- 표는 일반 표, 병합 셀, 테두리 없는 표, 회전 표로 표시합니다.
- 레이아웃은 단일 열, 다단, 사이드바, 양식, 캡션 포함으로 구분합니다.
- 정답 Markdown·HTML과 블록 읽기 순서를 사람이 검수합니다.
- 텍스트, 표 구조, 읽기 순서, 치명 오류율을 각각 계산합니다.
여기서 치명 오류는 업무에 맞게 정해야 합니다. 예를 들어 재무 문서라면 금액과 연도 연결 오류, 계약서라면 조항 순서 누락, 논문 검색이라면 표 캡션과 본문 연결 오류가 후보가 됩니다.
평가표에는 평균과 함께 가장 약한 슬라이스도 남기세요. 전체 점수가 조금 높아도 운영 문서의 핵심 유형에서 반복 실패한다면, 더 큰 모델을 쓰거나 레이아웃 탐지와 검증 단계를 붙이는 쪽이 낫습니다.
직접 시험할 때 필요한 최소 흐름
공식 README 기준으로 Python 3.10 이상이 필요하며 vLLM 서버 실행에는 vLLM 0.11.1 이상이 안내돼 있습니다. 입력은 PNG·JPEG·WebP 페이지 이미지이므로 PDF는 먼저 페이지별 이미지로 렌더링해야 합니다.
python -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements-vllm.txt
bash scripts/serve_vllm.sh Tencent/WeVisDoc-2B
다른 터미널에서는 다음처럼 한 페이지를 처리합니다.
python -m wevisdoc.client \
  --image page.png \
  --output results/page.md
이 글에서는 체크포인트를 내려받아 GPU 추론을 실행하지 않았습니다. 위 명령과 동작 설명은 2026년 9월 19일 확인한 공식 문서 기준이며, 성능 수치는 저자 보고 결과입니다.
어떤 팀에 맞고, 언제 다른 선택이 나을까요?
텍스트·표·수식을 하나의 Markdown 계열 출력으로 다루고 싶은 팀, 페이지 이미지 중심 파이프라인을 운영하는 팀에는 검토 가치가 있습니다. 2B와 4B를 같은 평가 세트에 돌려 정확도와 자원 비용을 비교하기도 편합니다.
반대로 좌표 기반 원문 하이라이트가 핵심이거나, 관리형 API와 지원 계약이 필수이거나, CPU만으로 대량 처리가 필요한 환경이라면 요구사항을 먼저 다시 봐야 합니다. 확인 시점의 Hugging Face 모델 카드에는 공식 Inference Provider 배포가 표시되지 않았습니다.
선택의 기준은 “공개 점수가 가장 높은가”보다 단순합니다. 내 문서의 가장 어려운 10%에서 표 관계와 읽기 순서를 얼마나 지키는가를 먼저 확인하세요.
핵심 정리: 다섯 가지 질문과 답
Q. WeVisDoc의 Overall만 비교해도 될까?
아닙니다. Overall과 별도로 표 TEDS, 읽기 순서 ROEdit, 입력 열화별 결과를 확인해야 합니다.
Q. 표 평가는 왜 문자 정확도만으로 부족할까?
셀 내용이 맞아도 행·열과 헤더 관계가 바뀌면 데이터 의미가 달라집니다. HTML 구조와 병합 셀 보존을 함께 봐야 합니다.
Q. 복잡한 레이아웃의 핵심 검수 항목은 무엇일까?
열 전환, 제목 계층, 캡션 연결, 각주 위치처럼 블록 사이의 읽기 순서를 따로 검사해야 합니다.
Q. 자체 평가 세트는 어떻게 나누면 좋을까?
깨끗한 PDF·스캔·촬영본을 분리하고, 표 유형과 레이아웃 유형별 슬라이스를 붙이는 방식이 실용적입니다.
Q. 공개 수치는 어떻게 해석해야 할까?
OmniDocBench v1.6과 PureDocBench에서 저자가 보고한 결과입니다. 실제 업무 정확도나 독립 재현 결과로 바꾸어 말하면 안 됩니다.
작업 환경을 함께 정리한다면
원본 문서와 파싱 결과를 자주 오가며 비교한다면 27인치 QHD 화면은 두 창을 나란히 두는 작업에 직접 연결됩니다. 삼성 뷰피니티 S6 LS27F610은 검색 결과에서 QHD와 세로 배치를 확인할 수 있어 긴 문서 검수용 후보로 골랐습니다. 연결 단자와 노트북 출력 규격, 책상 폭은 구매 전에 제품 페이지에서 다시 확인해야 합니다.
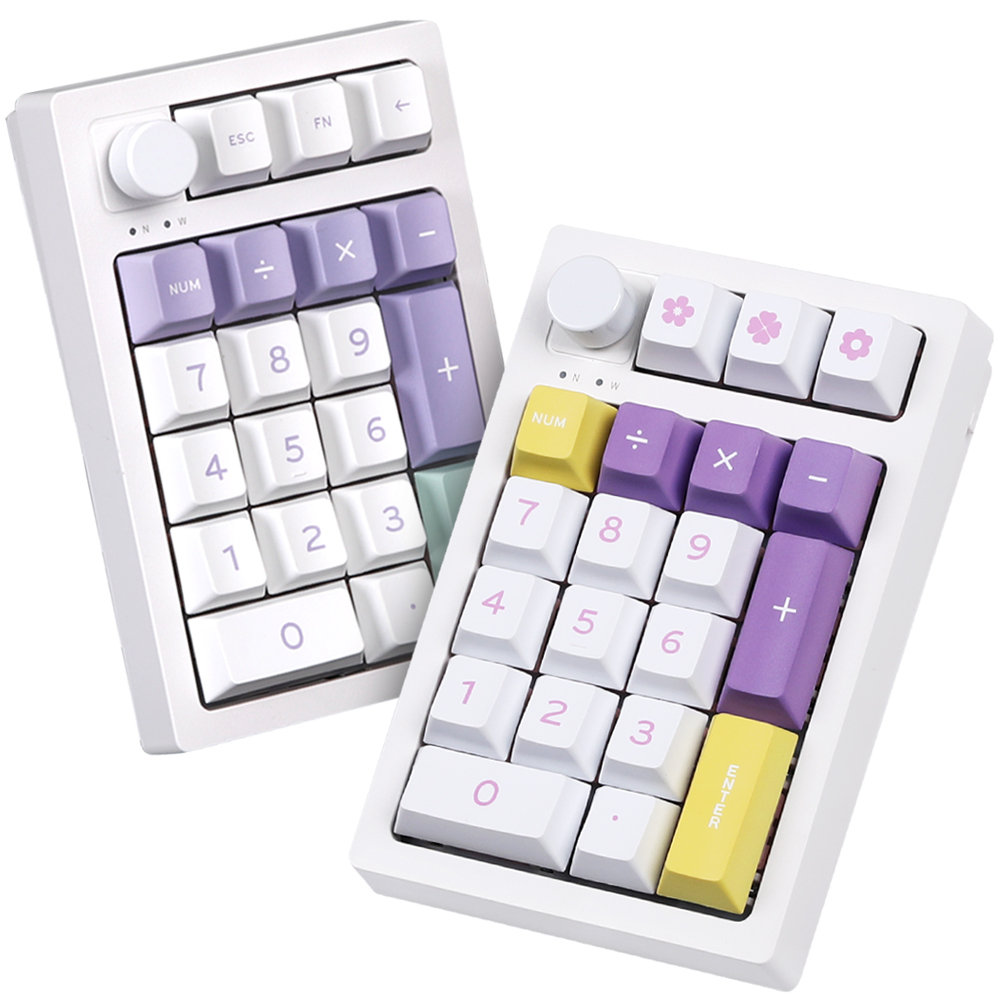
평가표에 셀 좌표와 오류 코드를 반복 입력한다면 별도 숫자 키패드가 기록 동선을 줄여 줍니다. 가츠 X21프로는 검색 결과에서 유·무선과 한손 단축키 용도를 확인할 수 있어 두 번째 역할로 선택했습니다. 운영체제 호환, 연결 방식, 단축키 설정 범위는 제품 페이지의 최신 조건을 확인하세요.
이 포스팅은 네이버 쇼핑 커넥트 활동의 일환으로, 판매 발생 시 수수료를 제공받습니다.
출처
- WeVisDoc 공식 GitHub: https://github.com/Tencent/WeVisDoc
- WeVisDoc 기술 보고서 v1, 2026-09-17: https://arxiv.org/html/2609.20423v1
- WeVisDoc-2B 모델 카드: https://huggingface.co/Tencent/WeVisDoc-2B
- WeVisDoc-4B 모델 카드: https://huggingface.co/Tencent/WeVisDoc-4B
- OmniDocBench 공식 저장소: https://github.com/opendatalab/OmniDocBench
- PureDocBench 논문: https://arxiv.org/abs/2605.07492
'AI > AI 최신 기술' 카테고리의 다른 글
| EvoSkill-GUI, 화면 에이전트가 같은 실패를 반복할 때 고치는 곳 (0) | 2026.09.20 |
|---|---|
| When2Think, 쉬운 질문까지 길게 답하는 AI를 어떻게 멈출까 (0) | 2026.09.20 |
| Claude Code 세션 협업, 뭘 써야 할까 (1) | 2026.09.15 |
| EvoSafeHarness, 보안 규칙을 고정하지 않고 어디까지 맡길까 (0) | 2026.09.14 |
| NCP-ArchPreview, 다음 토큰만 맞혀선 부족한 이유 (0) | 2026.09.14 |


댓글