NCP-ArchPreview, 다음 토큰만 맞혀선 부족한 이유
NCP-ArchPreview는 다음 토큰 예측을 버리지 않습니다. 대신 네 토큰마다 만든 잠재 표현에서 ‘다음 개념’도 함께 예측하고, 그 결과를 다시 토큰 생성에 넣어 문장보다 한 단계 큰 흐름을 학습합니다. 핵심은 단어 대신 생각하는 모델이 아니라, 토큰 목표와 압축된 개념 목표를 함께 훈련하는 구조입니다.
30초 요약
- NCP는 Next Concept Prediction의 약자로, 여러 토큰을 압축한 다음 잠재 개념을 예측합니다.
- NCP-ArchPreview는 토큰 인코더·개념 모듈·토큰 디코더를 잇고 NTP와 NCP를 함께 학습합니다.
- ‘개념’은 사람이 이름 붙인 주제가 아니라 제품 양자화 코드북에서 배운 잠재 표현입니다.
- 저자 평가의 이득은 유망하지만, 학습 시간이나 추론 속도가 그대로 빨라졌다는 뜻은 아닙니다.
- 공개 체크포인트는 약 8.94B 규모의 연구용 base model이며 대화형 모델이 아닙니다.
다음 토큰 예측에서 무엇이 막혔을까?
일반적인 자기회귀 언어 모델은 앞의 토큰을 보고 바로 다음 토큰의 확률을 높이는 방식으로 배웁니다. 문장이 길어져도 훈련 신호의 기본 단위는 여전히 한 토큰입니다.
가령 비가 오기 시작해 우산을이라는 입력 뒤에는 폈다가 자연스럽습니다. 하지만 글 전체에서는 ‘날씨 변화에 대응한다’는 더 큰 흐름도 함께 유지해야 합니다. NCP-ArchPreview는 이 큰 흐름을 별도의 잠재 목표로 학습시키자는 제안입니다.
다만 모델이 인간처럼 ‘우산을 펴야겠다’고 이해했다고 읽으면 곤란합니다. 여기서 개념은 사람이 붙인 꼬리표가 아니라, 모델 내부 상태를 압축하고 양자화해 만든 코드입니다.
NCP-ArchPreview는 개념을 어떻게 만들까?
작동 과정은 택배 분류에 비유할 수 있습니다. 낱개 물건인 토큰을 그대로 추적하면서, 네 개씩 묶은 상자에도 분류 코드를 붙이고 다음 상자의 코드를 예상하는 식입니다. 상자 코드가 낱개 배송을 대신하지는 않지만, 뒤에 올 묶음의 방향을 알려줍니다.
구조는 세 부분으로 나뉩니다.
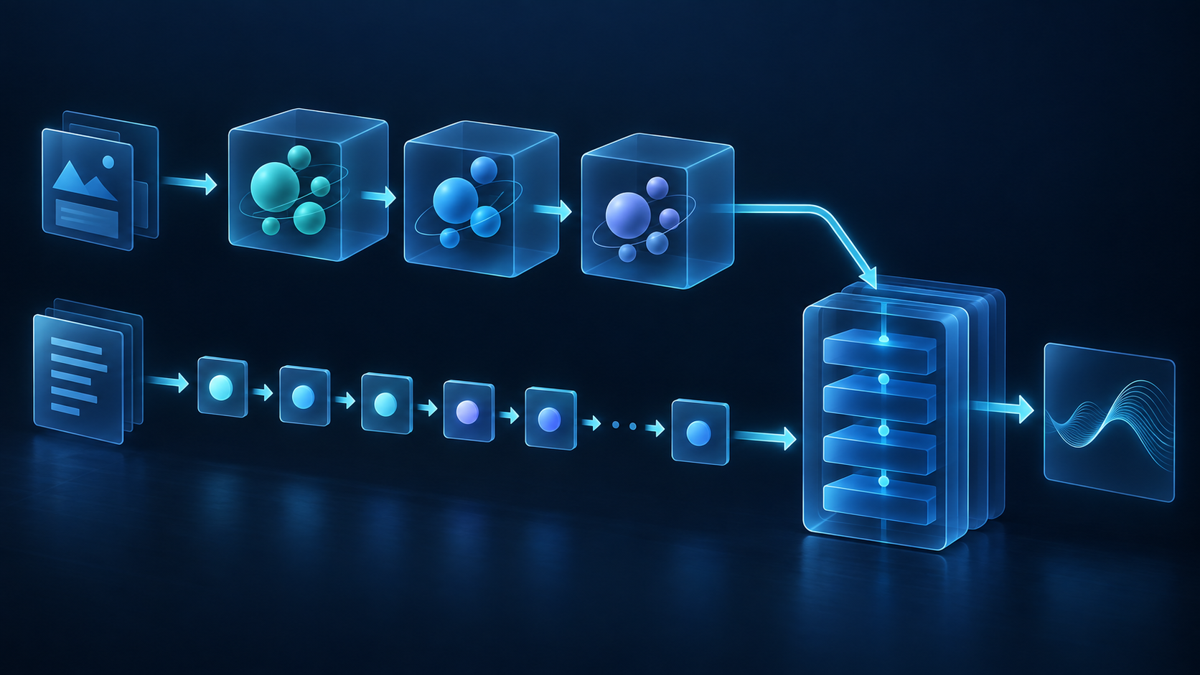
- 16층 Token Encoder가 문맥을 반영한 토큰 상태를 만듭니다.
- 연속된 네 토큰 상태를 평균 풀링해 하나의 연속 개념 표현으로 압축합니다.
- 8층 Concept Module이 다음 개념을 예측하고, 16층 Token Decoder가 이 신호와 토큰 상태를 받아 다음 토큰 확률을 냅니다.
개념 어휘는 Product Quantization, 즉 제품 양자화로 만듭니다. 32개 코드북에 각각 128개의 128차원 코드워드를 두고, 연속 표현을 여러 작은 코드 선택으로 나타냅니다. 거대한 단일 개념 사전 하나를 두는 대신, 여러 코드북의 조합으로 잠재 표현을 구성하는 셈입니다.
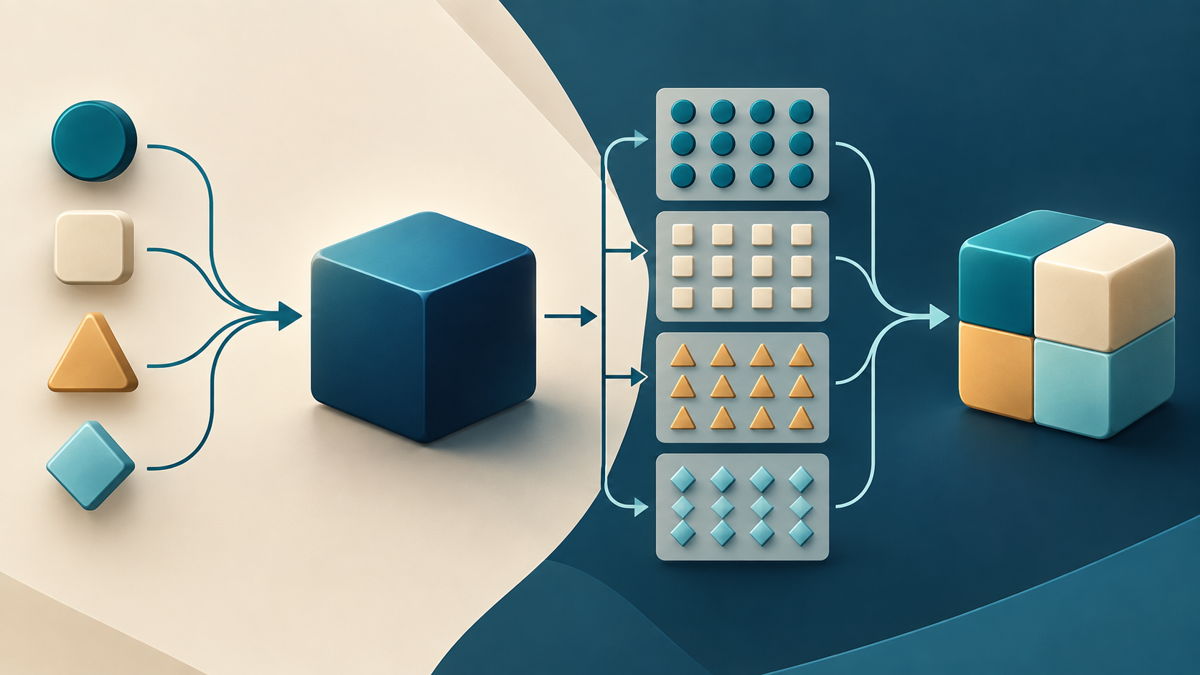
예측한 개념은 시간축을 맞춰 토큰 해상도로 반복된 뒤 디코더에 들어갑니다. 미래 토큰에서 만든 정답 개념이 현재 토큰 생성에 새어 들어가지 않도록 인과 정렬을 지키는 부분이 중요합니다.
입력과 출력은 기존 모델과 어떻게 다를까?
겉으로 보이는 생성 인터페이스는 그대로입니다. 문자열을 토큰화해 넣고 다음 토큰을 순서대로 받습니다. 차이는 훈련 중간에 개념 경로가 하나 더 있다는 점입니다.
입력 토큰
  ├─> Token Encoder ─> 4개씩 평균 풀링 ─> Concept Module ─> 다음 개념 예측
  └───────────────────────────────> Token Decoder <───────┘
                                             └─> 다음 토큰 확률
문서 기반의 단순 예로 배포 중 오류가 발생했다. 로그를 확인하고가 들어왔다고 해보겠습니다. NTP 경로는 바로 다음 토큰을 맞히고, NCP 경로는 네 토큰 묶음에서 나온 잠재 코드의 다음 상태를 예측합니다. 실제 코드가 ‘오류 대응’처럼 사람이 읽을 수 있는 이름을 갖는다는 뜻은 아니며, 이 예시는 정보 흐름을 설명하기 위한 것입니다.
훈련 목표도 하나가 아닙니다. 모델 카드는 표준 다음 토큰 교차 엔트로피인 NTP, 다음 연속 개념을 맞히는 NCP, 코드북을 인코더 표현에 맞추는 VQ 목표를 함께 사용한다고 설명합니다.
성능 수치는 어디까지 믿어야 할까?
2026년 9월 9일 공개된 기술 보고서에서 모델 규모는 약 8.94B, 대규모 학습량은 Dolma-3의 5.73T 토큰으로 제시됐습니다. 저자 평가 기준 Stage 1 종합 평균은 49.04로 OLMo-3-7B의 46.59보다 2.45점 높았고, GSM8K 차이는 5.99%포인트였습니다.
| 비교 항목 | OLMo-3-7B Stage 1 | NCP-ArchPreview Stage 1 |
|---|---|---|
| Overall AVG | 46.59 | 49.04 |
| GSM8K | 39.27 | 45.26 |
| HumanEval | 27.10 | 31.38 |
이 표는 저자 보고서의 평가 결과이지 독립 재현 결과가 아닙니다. 모델·프롬프트·체크포인트·평가 구현이 바뀌면 결과도 달라질 수 있습니다.
‘51.3%의 토큰으로 OLMo-3-7B 최종 학습 손실에 도달했다’는 문장도 범위를 좁혀 읽어야 합니다. 이는 기준 손실까지 필요한 토큰 예산 비교이며, 실제 학습 시간이 1.95배 빨라졌거나 추론 처리량이 늘었다는 측정이 아닙니다.
지금 직접 써볼 수 있을까?
Hugging Face에는 Stage 1 중간 체크포인트가 공개돼 있습니다. 모델 카드의 예시는 transformers에서 사용자 정의 모델 코드를 허용해 로드하지만, 약 8.94B BF16 가중치와 활성값·KV 캐시를 담을 CUDA 환경이 필요합니다.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "ArchSpace-Collection/NCP_ArchPreview_dolma3_8.9B_Stage1_Step1300000"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    trust_remote_code=True,
    torch_dtype=torch.bfloat16,
).eval().to("cuda")
이 코드는 모델 카드에 근거한 로딩 예시이며 이 글을 위해 실행한 결과는 아닙니다. trust_remote_code=True는 저장소의 사용자 정의 Python 코드를 실행하므로, 실제 사용 전 파일을 검토하고 모델과 토크나이저의 revision을 같은 Hub commit으로 고정하는 편이 안전합니다.
공개 모델은 대화형으로 정렬된 챗봇이 아니라 사전학습 base model입니다. 연구·학습 동역학 분석·추가 사전학습에는 맞지만, 채팅 앱에 바로 연결해 정확한 답을 기대할 대상은 아닙니다. 학습 코드는 모델 카드에서 아직 coming soon으로 안내됩니다.
이 접근이 필요한 경우와 필요 없는 경우
잠재 공간 언어 모델의 구조를 연구하거나, 토큰 수준 손실 외에 계층적 학습 신호를 실험하려는 개발자라면 살펴볼 이유가 있습니다. 코드북 일부와 예측 헤드만 조정하는 도메인 적응 실험도 후속 연구 주제로 흥미롭습니다.
반대로 작은 GPU에서 바로 챗봇을 띄우거나, 검증된 운영 처리량을 원하는 팀에는 맞지 않습니다. 사람에게 해석 가능한 개념 추출기가 필요할 때도 선택이 어긋납니다. 모델 카드가 분명히 밝히듯 개별 잠재 코드는 인간이 이해할 수 있는 개념과 일대일 대응하지 않습니다.
현재 단계에서 가장 좋은 다음 행동은 숫자 하나에 기대기보다 세 가지를 확인하는 것입니다. 기술 보고서의 비교 조건을 읽고, 사용할 체크포인트를 정확히 고른 뒤, 학습 코드 공개 여부와 독립 재현 결과를 기다리며 작은 평가셋으로 목적 적합성을 따져보는 순서입니다.
핵심 정리: 다섯 가지 질문과 답
Q. NCP는 다음 토큰 예측을 없애나요?
아닙니다. NCP-ArchPreview는 NTP를 유지하면서 다음 잠재 개념을 예측하는 목표를 함께 학습합니다.
Q. 여기서 개념은 사람이 읽을 수 있는 주제인가요?
보장되지 않습니다. 네 토큰 상태를 압축하고 제품 양자화 코드북으로 표현한 학습된 잠재 코드입니다.
Q. 예측한 개념은 어디에 쓰이나요?
인과적으로 정렬된 뒤 토큰 디코더에 전달돼 다음 토큰 분포를 만드는 보조 신호가 됩니다.
Q. 보고된 51.3%는 학습 시간이 절반이라는 뜻인가요?
아닙니다. OLMo-3-7B의 기준 손실에 도달하는 데 든 토큰 예산을 비교한 값이며 벽시계 시간이나 추론 속도 측정이 아닙니다.
Q. 공개 체크포인트를 챗봇으로 바로 써도 되나요?
연구용 base model이라 대화형 정렬이 돼 있지 않습니다. 사용자 정의 코드와 실행 자원, 출력 위험을 검토한 뒤 제한된 평가부터 진행하는 편이 맞습니다.
출처
- NCP-ArchPreview Technical Report: https://arxiv.org/abs/2609.10715
- NCP-ArchPreview 8.9B Stage 1 모델 카드: https://huggingface.co/ArchSpace-Collection/NCP_ArchPreview_dolma3_8.9B_Stage1_Step1300000
'AI > AI 최신 기술' 카테고리의 다른 글
| Claude Code 세션 협업, 뭘 써야 할까 (1) | 2026.09.15 |
|---|---|
| EvoSafeHarness, 보안 규칙을 고정하지 않고 어디까지 맡길까 (0) | 2026.09.14 |
| 토큰이 녹는다, Codex·Claude Code 토큰 최적화, 파일을 덜 읽게 만드는 설정 (0) | 2026.09.14 |
| GPT 6 Astra + Higgsfield Plugin, 어디서 연결하고 어떻게 움직일까 (0) | 2026.09.13 |
| OpenRouter란? 모델은 고르고 제공자 라우팅은 맡기는 법 (0) | 2026.09.13 |


댓글