OpenRouter란? 모델은 고르고 제공자 라우팅은 맡기는 법
OpenRouter는 여러 회사의 AI 모델을 한 API 형식으로 호출하게 해 주는 중간 계층입니다. 애플리케이션은 사용할 모델을 정하고, OpenRouter는 그 모델을 서비스하는 제공자 가운데 요청을 보낼 곳을 고르거나 실패 시 다른 경로를 시도합니다. 모델마다 인증·요청 코드를 따로 관리하느라 막혔다면 이 둘을 구분하는 것부터 시작하면 됩니다.
30초 요약
- 하나의 API 엔드포인트와 공통 요청 형식으로 여러 AI 모델을 호출합니다.
model은 어떤 모델을 쓸지,provider는 그 모델을 어느 제공 경로로 실행할지 정합니다.models배열을 쓰면 첫 모델 실패 시 다음 모델을 순서대로 시도할 수 있습니다.- 편해지는 대신 비용·기능 지원·데이터 정책은 실제 선택된 모델과 제공자 기준으로 확인해야 합니다.
OpenRouter는 정확히 무엇을 대신할까요?
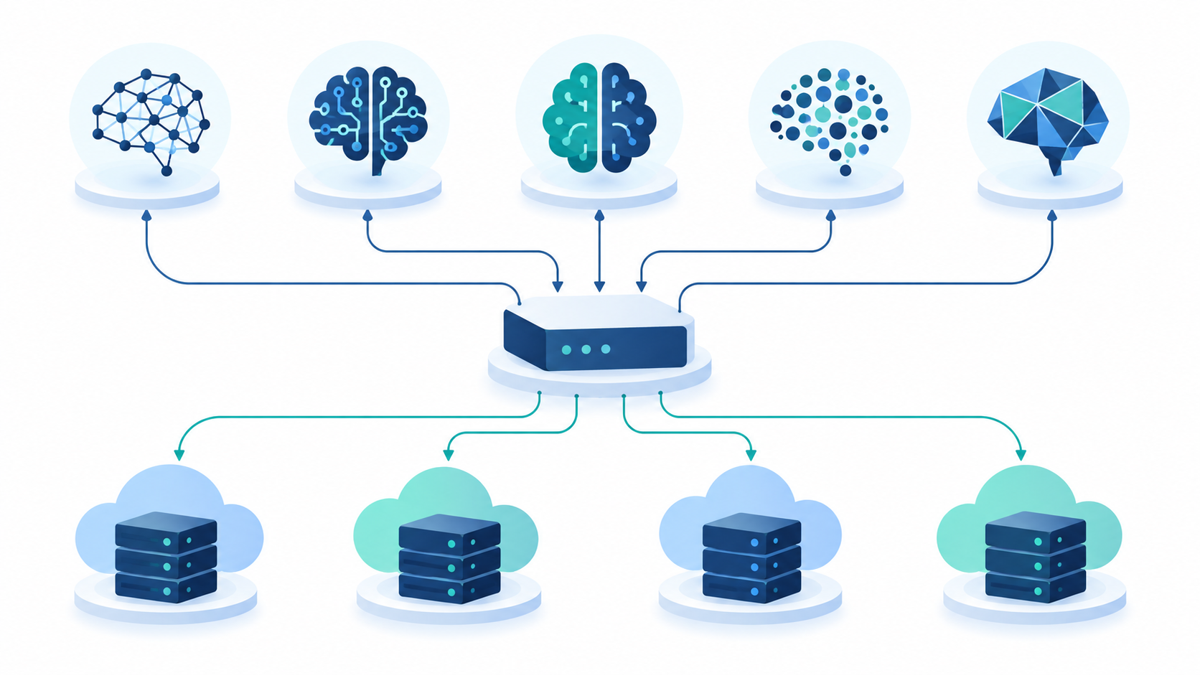
여러 음식점의 주문을 한 화면에서 받는 배달 앱을 떠올리면 쉽습니다. 메뉴가 AI 모델이고 조리하는 지점이 제공자라면, OpenRouter는 주문 형식을 맞추고 어느 지점으로 보낼지 정하는 창구에 가깝습니다.
개발자는 https://openrouter.ai/api/v1/chat/completions로 모델 ID와 메시지를 보냅니다. OpenRouter 공식 API 문서에 따르면 요청과 응답은 OpenAI Chat API와 비슷한 공통 형식으로 정리됩니다.
덕분에 모델을 바꿔 비교할 때 연결 코드 전체를 매번 새로 짜는 일을 줄일 수 있습니다. 다만 모든 모델의 기능이 같아지는 것은 아닙니다. 선택한 모델이 지원하지 않는 매개변수는 무시될 수 있으므로 도구 호출, 구조화 출력, 이미지 입력 같은 기능은 모델별 지원 여부를 따로 봐야 합니다.
모델과 제공자는 다른 선택입니다
OpenRouter를 이해할 때 가장 자주 엉키는 부분입니다. 모델 선택은 답을 만드는 두뇌를 고르는 일이고, 제공자 라우팅은 그 모델을 실행할 경로를 고르는 일입니다.
| 구분 | 요청에서 보는 값 | 결정하는 것 |
|---|---|---|
| 모델 선택 | model 또는 models |
어떤 모델이 답할지 |
| 제공자 선택 | provider |
같은 모델을 어느 제공 경로로 실행할지 |
| 모델 fallback | models의 순서 |
앞 모델이 실패하면 다음에 시도할 모델 |
모델 하나를 지정해도 그 모델을 공급하는 엔드포인트가 여러 개일 수 있습니다. 공식 API 문서는 기본 라우팅이 가격과 가용 자원을 고려하고, 5xx 오류나 사용량 제한이 발생하면 다른 제공자나 GPU 경로로 넘길 수 있다고 설명합니다.
여기서 ‘자동’은 ‘아무 모델이나 마음대로 바꾼다’는 뜻이 아닙니다. 같은 모델 안의 제공 경로 선택과, 다른 모델로 넘어가는 fallback은 별도 층입니다.
최소 요청은 어떻게 생겼을까요?
아래는 공식 Quickstart를 줄여 쓴 문서 기반 Python 예제입니다. 실제 API 키로 호출해 측정한 실행 기록은 아니며, 모델 ID와 지원 기능은 사용할 때 공식 모델 목록에서 다시 확인해야 합니다.
import os
import requests

response = requests.post(
    "https://openrouter.ai/api/v1/chat/completions",
    headers={
        "Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "openai/gpt-5.2",
        "messages": [
            {"role": "user", "content": "이 문장을 열 글자로 요약해 줘: ..."}
        ],
    },
    timeout=60,
)
response.raise_for_status()
result = response.json()
print(result["choices"][0]["message"]["content"])
print(result["model"], result.get("usage"))
입력은 모델 ID와 역할별 메시지입니다. 예상되는 출력은 choices[0].message.content의 답변이며, 응답의 model과 usage를 함께 남기면 실제 선택 모델과 토큰·비용 정보를 추적할 수 있습니다.
API 키는 코드에 직접 적지 않고 환경 변수나 비밀 관리 도구에서 읽는 편이 안전합니다. 기존 OpenAI SDK를 쓰는 코드라면 공식 문서처럼 base_url을 OpenRouter 주소로 바꾸는 방식도 있지만, OpenRouter 전용 필드는 extra_body 같은 확장 인자로 전달해야 할 수 있습니다.
여러 모델을 순서대로 넘기는 fallback
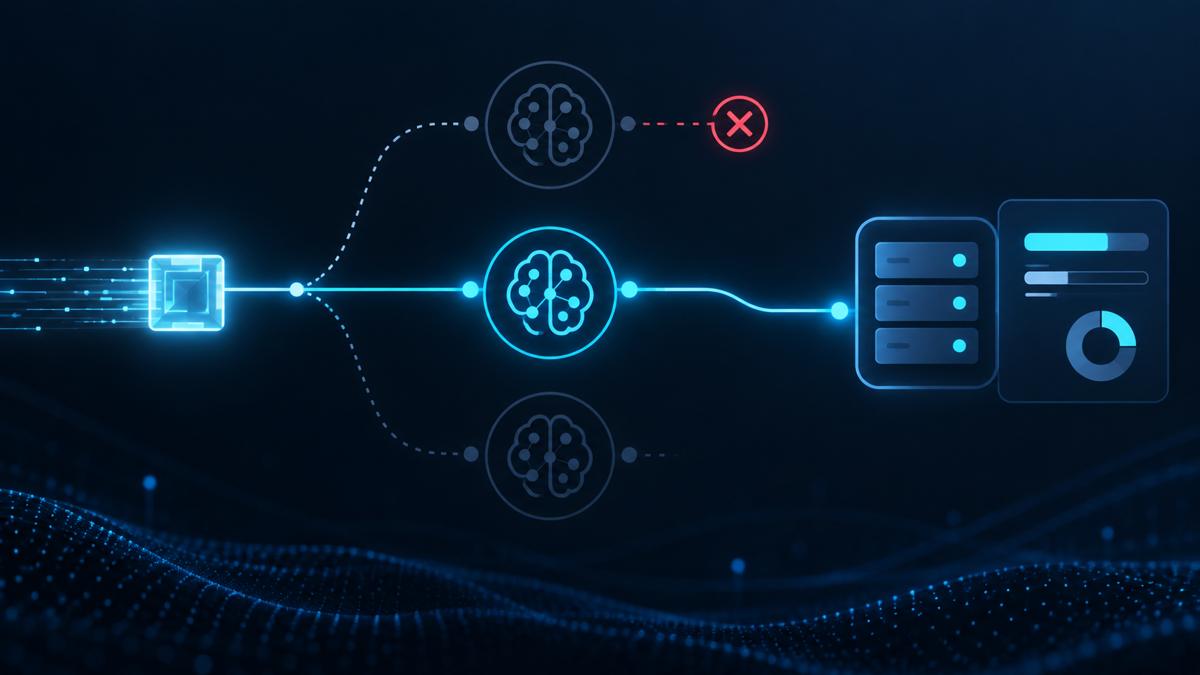
한 모델만 지정하면 제공자 경로의 대체는 가능해도, 모델 자체를 바꾸는 규칙은 개발자가 따로 정하지 않은 상태입니다. 다른 모델까지 순서대로 시도하려면 models 배열을 사용합니다.
payload = {
    "models": [
        "첫-번째-모델-ID",
        "두-번째-모델-ID",
    ],
    "messages": [
        {"role": "user", "content": "JSON으로 제목 후보 3개를 만들어 줘"}
    ],
}
공식 Model Fallbacks 문서에 따르면 첫 모델이 오류를 반환하면 다음 모델을 시도합니다. 문맥 길이 검증 오류, 콘텐츠 필터 거절, 사용량 제한, 서비스 중단 등이 그 조건이며, 마지막 후보도 실패하면 해당 오류가 반환됩니다.
fallback은 성공 보증이 아니라 실패 경로를 미리 정하는 기능입니다. 모델이 바뀌면 답의 품질과 말투뿐 아니라 가격, 문맥 길이, 구조화 출력 지원도 달라질 수 있습니다. 최종 응답의 model과 usage를 로그에 남겨야 “분명 싼 모델을 앞에 뒀는데 비용은 왜 다르지?” 같은 수수께끼를 줄일 수 있습니다.
자동 라우팅을 어디까지 맡길까요?
초기 실험이나 여러 모델 비교라면 기본 라우팅부터 시작하는 편이 단순합니다. 한 API 키와 공통 응답 형식으로 후보를 바꾸면서, 실제 실패율·지연·비용을 애플리케이션 기준으로 기록할 수 있기 때문입니다.
반대로 특정 제공자와의 계약, 지역 처리, 데이터 보존 조건, 기능 호환성이 필수라면 자동 선택 범위를 좁혀야 합니다. 편한 자동문도 출입 명단이 필요한 사무실에서는 그냥 열어 둘 수 없는 것과 같습니다.
실무에서는 다음 순서가 무난합니다.
- 작업에 필요한 기능을 먼저 적습니다. 텍스트 생성만 필요한지, 도구 호출이나 구조화 출력까지 필요한지 구분합니다.
- 그 기능을 지원하는 모델 후보를 정합니다.
- 비용·지연·데이터 정책 가운데 절대 양보할 수 없는 조건을 제공자 필터에 반영합니다.
- fallback 후보가 원래 요청 형식과 출력 계약을 지킬 수 있는지 테스트합니다.
- 응답의 모델, 토큰, 비용, 오류 유형을 기록해 라우팅 규칙을 조정합니다.
개발 중에는 입력이 작고 결과 판정이 쉬운 테스트 세트를 먼저 만드는 편이 낫습니다. 모델 이름만 바꿔 보고 “잘 되네요”로 끝내면, 구조화 출력이 깨지거나 fallback에서 비용이 튀는 문제를 뒤늦게 만날 수 있습니다.
데이터는 어디를 지나갈까요?
요청은 OpenRouter만 거치고 끝나지 않습니다. 실제 추론을 맡는 제공자에게 전달되고, 웹 검색 같은 플러그인을 켰다면 별도 서비스도 요청을 처리할 수 있습니다.
OpenRouter의 공식 Data Collection 문서는 입력·출력 본문 로깅과 제품 개선 사용을 기본적으로 opt-in이라고 설명합니다. 대신 토큰 수와 지연 같은 요청 메타데이터는 저장합니다. 여기에 실제 제공자마다 학습·로그·보존 정책이 다르므로 OpenRouter 자체 정책만 확인해서는 충분하지 않습니다.
민감한 입력을 다룬다면 Zero Data Retention(ZDR, 데이터 무보존) 조건을 검토할 수 있습니다. 요청의 provider에 zdr: true를 지정하면 ZDR 정책을 가진 추론 엔드포인트로 제한할 수 있지만, 공식 문서상 이 조건은 사용자가 켠 플러그인이나 도구에 자동 적용되지 않습니다.
{
  "model": "사용할-모델-ID",
  "messages": [{"role": "user", "content": "민감정보를 제거한 입력"}],
  "provider": {"zdr": true}
}
가장 안전한 기본값은 비밀키, 개인정보, 고객 원문을 프롬프트에 넣지 않는 것입니다. 꼭 처리해야 한다면 계정 설정, 요청별 ZDR, 실제 제공자와 플러그인의 약관을 함께 확인해야 합니다.
언제 쓰고 언제 직접 연결할까요?
OpenRouter는 여러 모델을 빠르게 비교하거나 한 연결 지점에서 fallback을 관리하려는 팀에 잘 맞습니다. 기존 OpenAI 호환 클라이언트의 구조를 크게 바꾸지 않고 모델 후보를 넓히려는 경우에도 출발점이 됩니다.
한 제공자의 고유 기능을 깊게 쓰거나 중간 계층을 두지 않는 계약 구조가 필수라면 직접 API가 더 단순할 수 있습니다. 특정 제공자의 새 기능이 공통 스키마에 반영되기까지 차이가 생길 가능성도 고려해야 합니다.
공식 Python SDK도 선택지입니다. OpenRouterTeam 저장소는 Python 3.10 이상을 요구하며, 2026년 9월 13일 확인 기준 최신 릴리스는 2026년 9월 11일의 v1.1.139입니다. 이 버전은 Python SDK의 릴리스일 뿐 OpenRouter 서비스 전체의 버전이나 출시일은 아닙니다.
처음 붙인다면 모델 하나로 최소 요청을 보내는 코드부터 작성하세요. 그다음 같은 입력 묶음으로 모델 후보를 비교하고, 마지막에 fallback과 데이터 정책 필터를 추가하면 무엇이 문제를 만들었는지 추적하기 쉽습니다.
핵심 정리: 다섯 가지 질문과 답
Q. OpenRouter는 AI 모델인가요?
아닙니다. 여러 AI 모델과 제공자를 공통 API 형식으로 연결하고 요청을 라우팅하는 중간 계층입니다.
Q. model과 provider는 같은 뜻인가요?
다릅니다. model은 답을 만들 모델을, provider는 그 모델을 실행할 제공 경로와 조건을 정합니다.
Q. 모델 장애가 나면 항상 다른 모델로 넘어가나요?
아닙니다. 다른 모델까지 넘기려면 우선순위를 담은 models 배열 등 fallback 규칙을 명시해야 하며, 마지막 후보도 실패할 수 있습니다.
Q. fallback을 쓰면 비용은 첫 모델 기준인가요?
아닙니다. 공식 문서상 최종 사용된 모델 기준으로 과금되므로 응답의 model과 usage를 함께 확인해야 합니다.
Q. ZDR을 켜면 모든 처리 경로에서 데이터가 남지 않나요?
그렇게 단정할 수 없습니다. ZDR은 추론 제공자 라우팅에 적용되며, 별도로 켠 플러그인과 도구의 데이터 정책은 따로 확인해야 합니다.
출처
'AI > AI 최신 기술' 카테고리의 다른 글
| 토큰이 녹는다, Codex·Claude Code 토큰 최적화, 파일을 덜 읽게 만드는 설정 (0) | 2026.09.14 |
|---|---|
| GPT 6 Astra + Higgsfield Plugin, 어디서 연결하고 어떻게 움직일까 (0) | 2026.09.13 |
| Ponytail Codex에 적용하기 AGENTS.md, 짧은 코드가 안전 규칙을 지우지 않게 (0) | 2026.09.12 |
| Ponytail 사용법, Claude Code 과잉 구현을 줄이는 법 (0) | 2026.09.12 |
| GPT-6 Astra, 긴 에이전트 작업에 바로 써도 될까 (0) | 2026.09.11 |


댓글