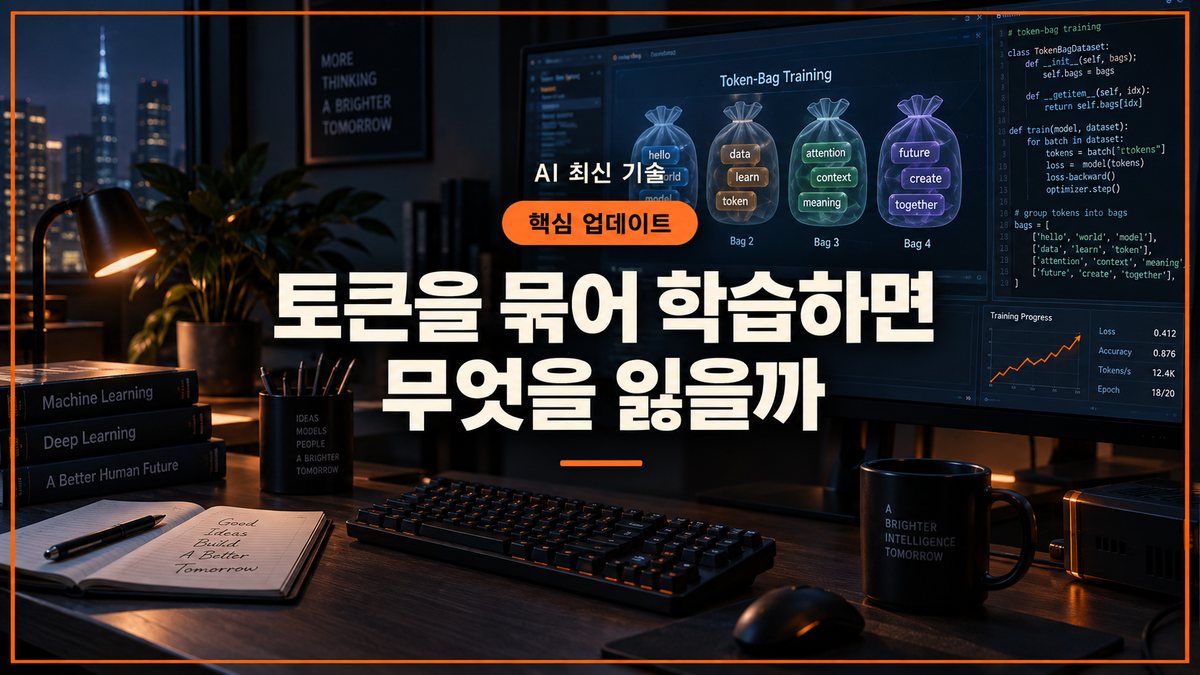
토큰 중첩 학습, 두 텍스트를 한 번에 예측해도 되는 이유와 멈춰야 할 지점
트랜스포머가 두 텍스트 흐름을 ‘동시에’ 예측한다는 말은, 보통 두 답변을 병렬 생성한다는 뜻이 아닙니다. Token Superposition Training(TST)은 학습 초기에 이웃한 여러 토큰을 한 묶음으로 평균 내고 다음 묶음의 토큰 집합을 맞히게 하는 방식입니다. 묶음 안의 순서를 버리는 대신, 학습 중 더 많은 텍스트를 통과시키는 선택이라서 추론 단계까지 그대로 가져가면 안 됩니다.
30초 요약
- TST는 추론 기능이 아니라 사전학습 루프를 바꾸는 방법입니다.
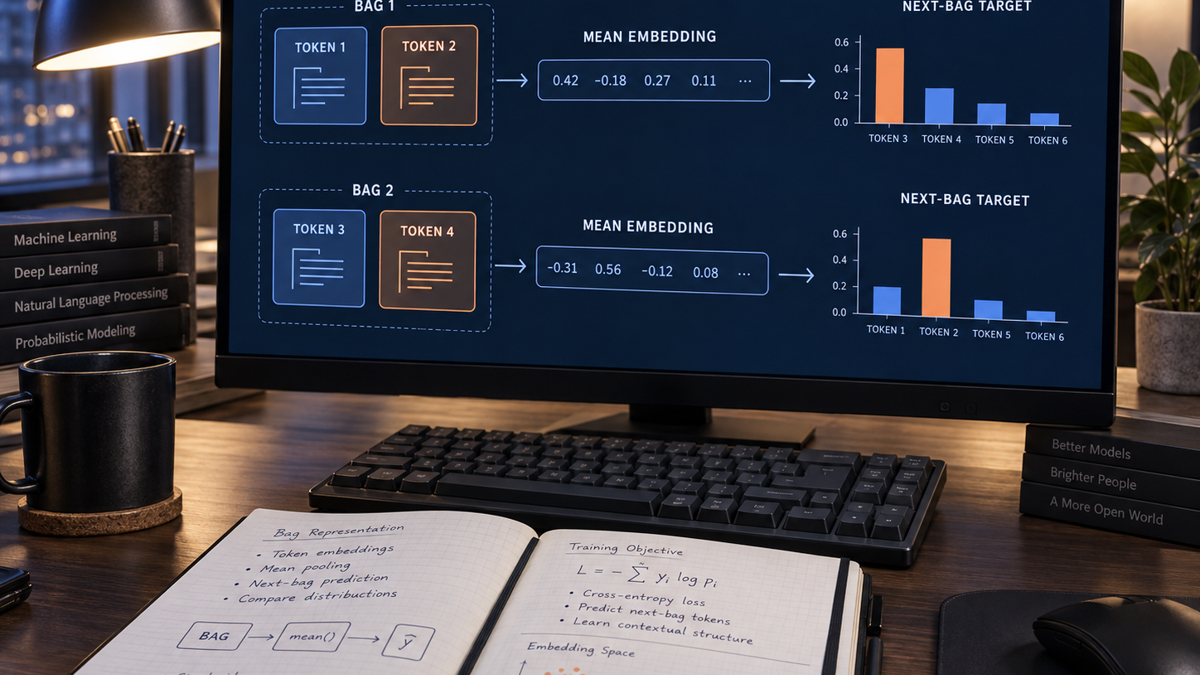
- 입력은 연속 토큰 임베딩의 평균, 정답은 다음 토큰 묶음의 평균 교차엔트로피입니다.
- 묶음 내부 순서는 사라지므로 TST만으로 학습한 모델은 정상적인 다음 토큰 생성에 쓸 수 없습니다.
- 그래서 일반 다음 토큰 학습으로 되돌리는 회복 단계가 핵심입니다.
두 텍스트 흐름을 섞는다는 말의 정확한 뜻은 무엇일까?
표준 인과 언어 모델은 앞 토큰을 보고 다음 한 토큰의 확률분포를 예측합니다. 반면 TST의 초반 단계는 연속된 s개 토큰을 한 bag으로 접습니다. 예를 들어 오늘 / 비가 / 온다 / 그래서라는 네 토큰을 s=2로 묶으면, 모델이 보는 위치는 두 개가 되고 각 위치는 두 임베딩의 평균입니다.
표준: [오늘] → [비가] → [온다] → [그래서]
TST:  mean([오늘, 비가]) → mean([온다, 그래서])
다음 정답도 한 토큰이 아닙니다. 한 latent 위치에서 다음 bag에 포함된 여러 토큰에 평균 교차엔트로피를 적용합니다. 즉 하나의 logit 분포가 다음 위치 여러 개의 토큰 집합과 맞도록 학습되는 셈입니다. 정확한 다음 위치 하나를 맞히는 목표는 아닙니다.
여기서 ‘선형 중첩’은 평균 연산을 가리키는 편한 설명이지, 모델이 두 문장을 독립 채널처럼 완벽하게 분해한다는 보장은 아닙니다. 같은 확률분포에 여러 정답을 얹으면 어떤 토큰이 몇 번째에 와야 하는지는 의도적으로 약해집니다.
왜 속도 이득이 생기지만, 문장 생성에는 바로 못 쓸까?
TST 공식 설명은 첫 20~40% 학습 동안 이 bag 단위 목표를 쓰고, 나머지 구간은 보통의 next-token prediction으로 학습한다고 밝힙니다. Transformer가 처리하는 latent 시퀀스 길이가 줄어드니, 같은 연산 예산에서 더 많은 원문 토큰을 보게 되는 것이 출발점입니다.
공식 실험에서는 270M·600M·3B dense 모델과 10B-A1B MoE에서 검증했고, 3B와 10B 설정에서 같은 최종 손실 기준 대략 2배의 wall-clock 이득을 보고했습니다. 다만 이는 동일 FLOPs·동일 최종 손실이라는 비교 조건의 결과입니다. 데이터 토큰 총량을 같게 맞추면 기준 학습이 더 낫다고 명시돼 있어, ‘항상 두 배 빠르다’로 읽으면 곤란합니다.
추론에서 TST 목표만 쓴 모델이 내는 분포는 bag 안 여러 미래 위치가 섞인 분포입니다. 샘플링하면 순서가 섞인 잡음 같은 결과가 나올 수 있습니다. 회복 단계에서 다시 정확한 순서의 다음 토큰을 맞히게 해야 일반 언어 모델로 돌아옵니다. 평균을 냈다고 문장 두 줄을 동시에 쓸 수 있게 된 것은 아닙니다. 전철을 합승시켜 한 정거장에 빨리 도착한 것과, 각 승객의 좌석 번호까지 기억하는 일은 다릅니다.
실제 한계는 어디에서 드러날까?
첫째, bag size가 너무 크면 순서 정보와 개별 토큰 구분이 너무 많이 사라집니다. TST는 bag size에 U자형 민감도가 있고, 모델 규모에 따라 유리한 범위가 달라졌다고 보고합니다. 작은 모델과 큰 모델에 같은 s를 복사하는 것은 안전한 출발점이 아닙니다.
둘째, 회복 구간이 짧으면 손상된 출력 헤드를 되돌릴 시간이 부족합니다. 공식 실험에서 단계 비율 r이 0.5 이상이면 최종 손실이 나빠졌고, 조사한 규모에서는 0.2~0.4가 가까운 최적 범위였습니다. 중첩 단계와 회복 단계는 세트라는 뜻입니다.
셋째, 원인은 아직 확정되지 않았습니다. 입력 평균이 고주파 변동을 낮추는 효과인지, 임베딩 기하를 규제하는 효과인지에 대해 공식 글도 결정적 ablation이 부족하다고 적습니다. 성능 개선은 관찰됐지만 ‘언어 의미를 선형적으로 합성할 수 있어서’라고 단정할 근거는 부족합니다.
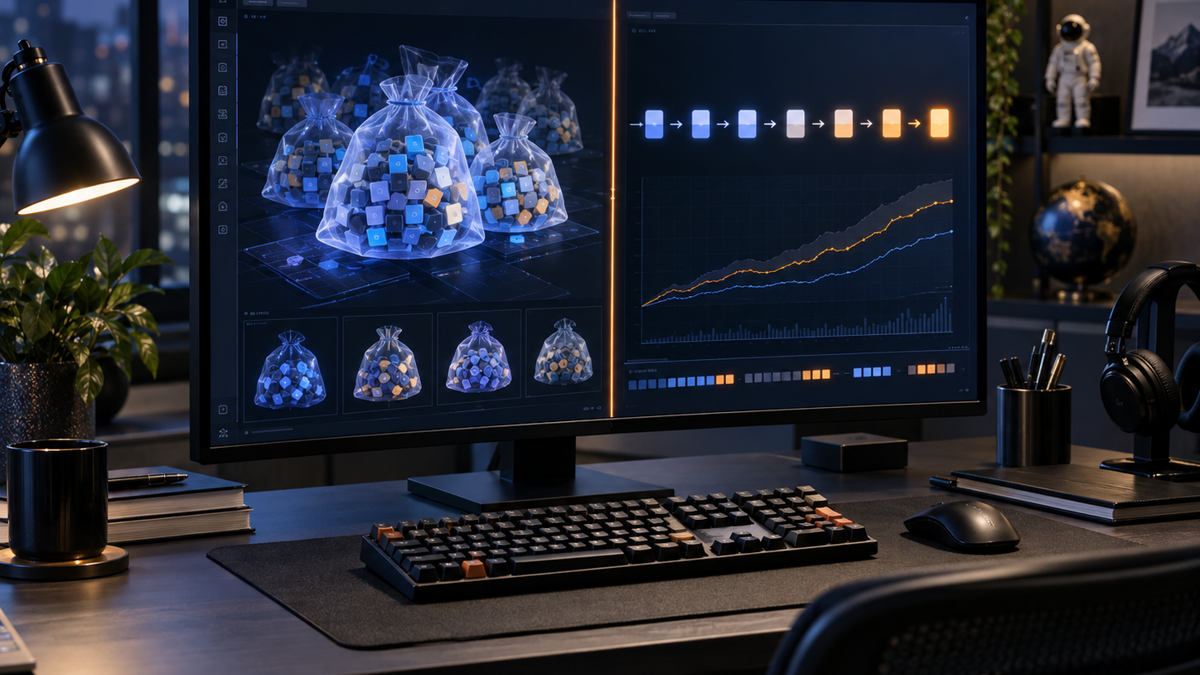
표현의 중첩과 TST를 같은 말로 부르면 왜 헷갈릴까?
해석가능성 연구에서 말하는 superposition은 제한된 표현 공간에 여러 feature가 비직교적으로 공존하는 현상을 뜻합니다. Anthropic의 toy model과 연구 업데이트는 이런 공유가 효율을 줄 수 있지만 간섭도 만들며, 강한 superposition 가설은 여전히 열린 문제라고 설명합니다.
더 직접적인 경고도 있습니다. 2026년 사전공개된 N-back 연구는 평가한 학습된 LLM에서 기억 부하가 커질수록 성능이 낮아지고, 최근의 경쟁 항목이 정답 회수에 간섭하는 패턴을 보고했습니다. 반대로 특정 과제에 맞춰 학습한 2층 인과 트랜스포머는 완벽히 풀 수 있었습니다. 구조가 가능하게 하는 것과, 범용 사전학습 모델이 실제로 안정적으로 하는 일은 다릅니다.
TST는 이 해석가능성 가설을 증명하는 기술이 아닙니다. 학습 초기에 순서를 압축해도 나중의 복구 학습으로 유용한 모델을 만들 수 있다는 하나의 사전학습 기법입니다. 둘을 구분하면 ‘두 흐름을 섞어도 된다’는 주장을 훨씬 좁고 검증 가능한 문장으로 바꿀 수 있습니다.
언제 실험하고, 언제 다른 방법을 택할까?
사전학습 파이프라인을 직접 돌리고, 학습 시간 또는 동일 FLOPs에서의 손실이 병목이라면 TST를 실험 후보에 올릴 수 있습니다. 이때 기준 run, bag size·단계 비율 sweep, 일반 next-token 회복 구간, 최종 downstream 평가를 한 묶음으로 설계해야 합니다.
반대로 서비스 추론 지연이 문제라면 TST는 직접 해법이 아닙니다. 결과 모델의 추론 구조는 기존 모델과 동일하므로, 추론 비용을 줄이려면 배치, KV cache, 양자화, speculative decoding처럼 서빙 경로를 건드리는 방법을 별도로 검토해야 합니다. 기존 사전학습을 하지 않는 애플리케이션 개발자에게도 바로 적용할 라이브러리 옵션은 아닙니다.
작게 검증한다면 아래처럼 판단 기준을 고정하는 편이 낫습니다.
- baseline과 TST의 모델 구조·옵티마이저·데이터를 같게 둡니다.
s와r을 한 번에 고정하지 말고 작은 sweep으로 회복 가능 범위를 찾습니다.- training loss만 보지 말고, 회복 뒤의 held-out loss와 실제 downstream 평가를 함께 봅니다.
- 동일 FLOPs, 동일 wall-clock, 동일 토큰 수 비교를 표에서 분리합니다. 이 셋을 섞으면 결론도 섞입니다.
작업 환경을 함께 정리한다면
아래 두 카드는 사전학습 자체를 빠르게 만드는 도구가 아닙니다. 긴 실험 로그와 비교표를 읽고 재현 설정을 정리하는 작업 환경에만 연결했습니다.
긴 학습 로그와 설정표를 읽을 때 화면 높이를 조절하는 용도입니다. TST의 성능을 높여 주는 장비는 아닙니다.
체크포인트와 실험 산출물을 옮기거나 보관할 때 고려할 수 있습니다. 용량·속도·호환성은 카드 정보와 판매 페이지에서 별도로 확인해야 합니다.
이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
출처
- Nous Research, Efficient pretraining with token superposition (2026년 9월 26일 확인). arXiv:2605.06546.
- Xiong et al., In-context superposition: human-like working memory interference in large language models (v3, 2026-08-13).
- Anthropic, Toy Models of Superposition (2026년 9월 26일 확인).
- Anthropic, Circuits Updates – January 2024 (2026년 9월 26일 확인).
핵심 정리: 다섯 가지 질문과 답
Q. TST는 두 문장을 동시에 생성하는 기능인가요?
아닙니다. 학습 초기에 여러 연속 토큰을 한 묶음으로 처리하는 사전학습 방법입니다.
Q. 무엇을 평균 내나요?
입력에서는 같은 bag 안 토큰 임베딩을 평균 내고, 출력에서는 다음 bag 토큰들의 평균 교차엔트로피를 계산합니다.
Q. 왜 일반 생성 전에 회복 학습이 필요한가요?
bag 내부 순서 정보가 사라져 TST 목표만으로는 정상적인 next-token 생성 분포가 되지 않기 때문입니다.
Q. 속도 이득은 어떤 조건의 결과인가요?
공식 실험의 동일 FLOPs·동일 최종 손실 비교에서 관찰된 결과이며, 동일 토큰 수 비교와는 구분해야 합니다.
Q. 서비스 추론 속도 문제에도 바로 쓰나요?
아닙니다. TST는 사전학습 루프를 바꾸며, 추론 구조 자체는 기존 방식과 같습니다.
'AI > AI 최신 기술' 카테고리의 다른 글
| IterSynth, 검색 기록이 길어질수록 답이 흐릴 때 무엇을 버려야 할까 (0) | 2026.09.27 |
|---|---|
| WanPE 역구성 방식, 한 줄 영상 프롬프트가 샷 계획으로 바뀌는 이유 (0) | 2026.09.26 |
| SWE-bench 점수, 높은데도 에이전트를 바로 맡기면 안 되는 이유 (0) | 2026.09.25 |
| JitMem, 에이전트 메모리를 저장할 때 요약하면 놓치는 단서 (0) | 2026.09.25 |
| GameHorizon 장기 행동 평가, 짧은 점수로 에이전트를 믿으면 놓치는 것 (0) | 2026.09.22 |


댓글