VeloxQuant-MLX로 긴 대화를 붙잡을 때, 압축률보다 먼저 볼 것
맥 로컬 LLM의 긴 대화는 VeloxQuant-MLX의 압축률만으로 판단하면 안 됩니다. 같은 대화에서 사실을 되찾는지, RSS가 어떻게 움직이는지, 생성 시간이 어떤지를 함께 적어야 합니다. 압축 비율이 Activity Monitor의 메모리 감소를 그대로 뜻하지는 않습니다.
이 글은 실제 실행 후기가 아니라 공식 문서 기반의 하루 데모 설계입니다. 목표는 최대 숫자가 아니라, 내 모델이 긴 문맥에서 어디까지 기억하는지 확인하는 일입니다.
30초 요약
- KV 캐시는 대화가 길수록 커지는 모델의 읽기 메모리입니다.
- VeloxQuant-MLX는
mlx_lm의 KV 캐시 표현을 바꾸거나 토큰을 정리하는 방식을 제공합니다.- 기본 캐시와 압축 캐시를 같은 질문으로 비교합니다.
- 사실 회수, RSS, 생성 시간을 한 표에 기록합니다.
KV 캐시는 왜 긴 대화에서 먼저 걸릴까?
LLM은 다음 토큰을 만들 때 앞선 내용을 참고하고, 그 상태를 KV 캐시에 쌓습니다. 대화가 길어질수록 이 공간도 커집니다.
MLX 공식 README는 Apple silicon에서 배열이 공유 메모리에 놓인다고 설명합니다. 모델 가중치와 KV 캐시는 같은 메모리 예산 안에서 함께 봐야 합니다.
책장 속 책이 모델이라면 KV 캐시는 읽다 꽂아 둔 색인입니다. 색인을 가볍게 만들 수는 있어도, 너무 거칠게 줄이면 예전 페이지를 헷갈릴 수 있습니다.
VeloxQuant-MLX는 무엇을 바꾸나?
VeloxQuant-MLX는 Apple Silicon의 mlx_lm 모델 KV 캐시를 대상으로 하는 오픈소스 프로젝트입니다. 공식 README는 양자화, 토큰 제거·병합, 층 사이 압축을 같은 KVCacheConfig 경로로 선택할 수 있다고 설명합니다.
첫 데모에는 README가 무보정 시작 후보로 제시하는 turboquant_rvq를 기준선과 비교하면 됩니다. 첫날 목표는 최대 압축이 아니라 같은 질문에 답이 남는지 확인하는 일입니다.
import mlx_lm
from veloxquant_mlx import KVCacheBuilder, KVCacheConfig

model, tokenizer = mlx_lm.load("mlx-community/Mistral-7B-Instruct-v0.3-4bit")
config = KVCacheConfig(method="turboquant_rvq", bit_width_inlier=1, seed=42)
model.make_cache = lambda *_args, **_kwargs: KVCacheBuilder.for_model(model, config)
README 기준 요구사항은 Apple Silicon M1 이상, Python 3.10 이상, MLX 0.18 이상, NumPy 1.26 이상입니다. 실제 모델과 설치 상태는 다를 수 있으니 환경을 분리해 확인합니다.
하루 데모는 두 실행이면 된다
모델, 프롬프트, 생성 토큰 상한, 온도를 고정하세요. 바뀌는 항목은 캐시 방식 하나만 남겨야 비교가 됩니다.
| 실행 | 캐시 | 기록 |
|---|---|---|
| A | 기본 캐시 | RSS, 생성 시간, 사실 회수 |
| B | turboquant_rvq |
RSS, 생성 시간, 사실 회수 |
사실 카드 8개를 순서대로 넣고 마지막에 첫 카드와 중간 카드의 내용을 묻습니다. 예를 들어 프로젝트 별칭은 민트, 배포 지역은 부산을 넣은 뒤 두 항목을 답하게 합니다.
정답 둘이면 사실 회수 2점, 하나면 1점, 모두 틀리면 0점으로 적으면 충분합니다. 이 점수는 모델의 일반 능력치가 아니라 이 대화에서의 보존 확인값입니다.

RSS와 압축률은 왜 다를 수 있나?
프로젝트 README는 일부 경로가 내부적으로 fp16을 보관할 수 있어 비트 단위 압축 비율과 RSS가 같지 않을 수 있다고 명시합니다. “16배” 같은 숫자를 곧바로 메모리 절약으로 읽으면 안 되는 이유입니다.
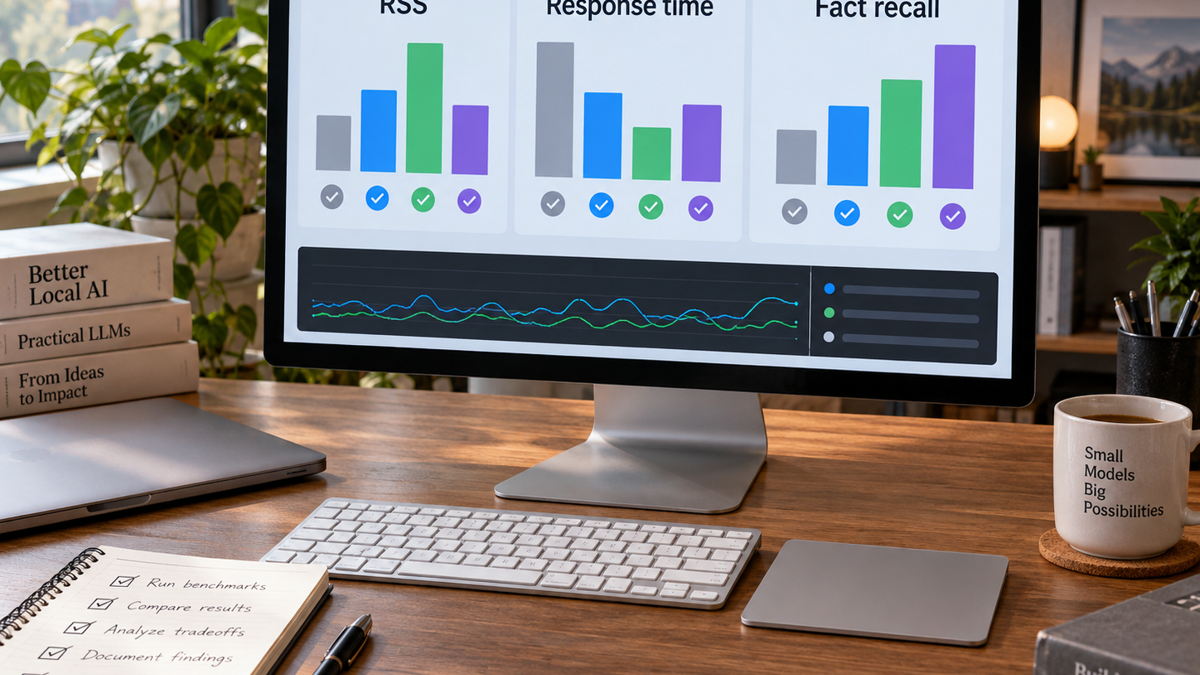
각 실행의 시작 전, 사실 카드 입력 후, 최종 질문 후의 RSS를 같은 도구에서 적으세요. RSS가 줄지 않아도 실패로 단정하지 말고 선택한 캐시 보관 방식을 먼저 확인합니다.
작은 모델에서는 Metal 커널 실행 오버헤드가 이득을 넘을 수도 있습니다. 느려졌다면 모델 크기와 문맥 길이를 함께 남겨 다음 선택의 조건으로 씁니다.
결과표로 다음 설정을 고르기
| 조건 | 사실 회수(0~2) | RSS 변화 | 생성 시간 |
|---|---|---|---|
| 기본 캐시 | |||
| 압축 캐시 |
사실 회수가 같고 자원 사용이 감당할 만하면 후보로 남길 수 있습니다. 오래된 사실을 놓친다면 비트 폭을 올리거나 다른 방식을 비교합니다.
토큰 제거·병합 계열은 특히 초반 사실 질문을 한 번 더 넣어 확인하세요. 긴 문맥 보존이 우선이면 한 가지 압축법을 모든 모델의 정답으로 고정하지 않는 편이 안전합니다.
맞는 경우와 다음 행동
Apple Silicon 맥에서 mlx_lm을 이미 쓰고, 긴 대화를 실험하려는 개발자에게 맞습니다. 반대로 문맥을 무조건 보존해야 하는 업무라면 요약·세션 분리·외부 기억 저장소도 함께 검토해야 합니다.
프로젝트는 MIT 라이선스를 표시하지만 운영 적합성이나 지원을 보장하지는 않습니다. 자신의 모델·입력 길이·정확도 기준으로 재현 테스트를 하세요.
기본 캐시와 VeloxQuant-MLX turboquant_rvq를 같은 모델·프롬프트·생성 토큰 상한으로 비교해.
사실 카드 8개와 마지막 회수 질문을 넣고, RSS·생성 시간·사실 회수를 CSV에 기록해.
측정하지 않은 값을 추정하지 말고 실패 시 패키지 버전, macOS, 칩, 모델명, 오류를 출력해.
이 프롬프트의 핵심은 결과 보장이 아니라 비교 조건과 오류 단서를 남기는 데 있습니다.
작업 환경을 함께 정리한다면
외장 화면에 비교 화면을 나눠 볼 때 연결 역할의 후보입니다.
결과와 다음 실행 조건을 기록하는 입력 보조 역할의 후보입니다.
이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
출처
- VeloxQuant-MLX 공식 저장소: https://github.com/rajveer43/VeloxQuant-MLX
- MLX 공식 저장소: https://github.com/ml-explore/mlx
핵심 정리: 다섯 가지 질문과 답
Q. VeloxQuant-MLX는 모델 자체를 더 작게 만드나요?
주 대상은 mlx_lm 모델의 KV 캐시입니다.
Q. 압축률만 보면 되나요?
아닙니다. 사실 회수, RSS, 생성 시간을 함께 봅니다.
Q. 첫 설정은 무엇이 좋나요?
기본 캐시와 문서 기반 turboquant_rvq를 같은 조건에서 비교합니다.
Q. RSS가 안 줄면 실패인가요?
아닙니다. 캐시 보관 방식에 따라 압축 비율과 RSS는 다를 수 있습니다.
Q. 정확도가 중요한 대화에는 어떻게 하나요?
중요 사실은 외부 저장소에서 다시 불러오고, 자신의 입력으로 재현 테스트합니다.
'AI > 오픈 소스 소개' 카테고리의 다른 글
| ConnectOnion 함수 도구 연결, 에이전트가 무엇을 했는지 기록까지 남기는 법 (0) | 2026.09.26 |
|---|---|
| Orca Git worktree 데모, 에이전트 답이 섞일 때 비교부터 분리하는 법 (0) | 2026.09.25 |
| Smithers 0.35.0 복구 데모, 실패한 에이전트 작업을 처음부터 다시 돌리기 전에 (0) | 2026.09.22 |
| SandBase Harness, 도구 실행이 멈췄을 때 승인 흐름을 확인하는 법 (0) | 2026.09.20 |
| Obsidian 노트 검색 AI, 하루 MVP는 어디까지 만들까 (0) | 2026.09.14 |


댓글